Answers by Context.dev
Answers by Context.dev 是一款网络提取 API,能够执行实时网络调研,并按照用户定义的示例对象结构返回规范化的 JSON 响应以及相关的参考来源 URL 列表。
研究助理基于最长 2,000 个字符的自然语言提示词执行实时网络调研将提取的数据格式化为与所提供示例模板相匹配的 JSON 对象按首次发现的顺序返回提供参考的来源 URL,确保调研过程透明在配置相应选项后,能够在截止时间到期前交付已收集到的部分答案
Answers by Context.dev 是一款网络提取 API,能够执行实时网络调研,并按照用户定义的示例对象结构返回规范化的 JSON 响应以及相关的参考来源 URL 列表。
产品用途与官方定位
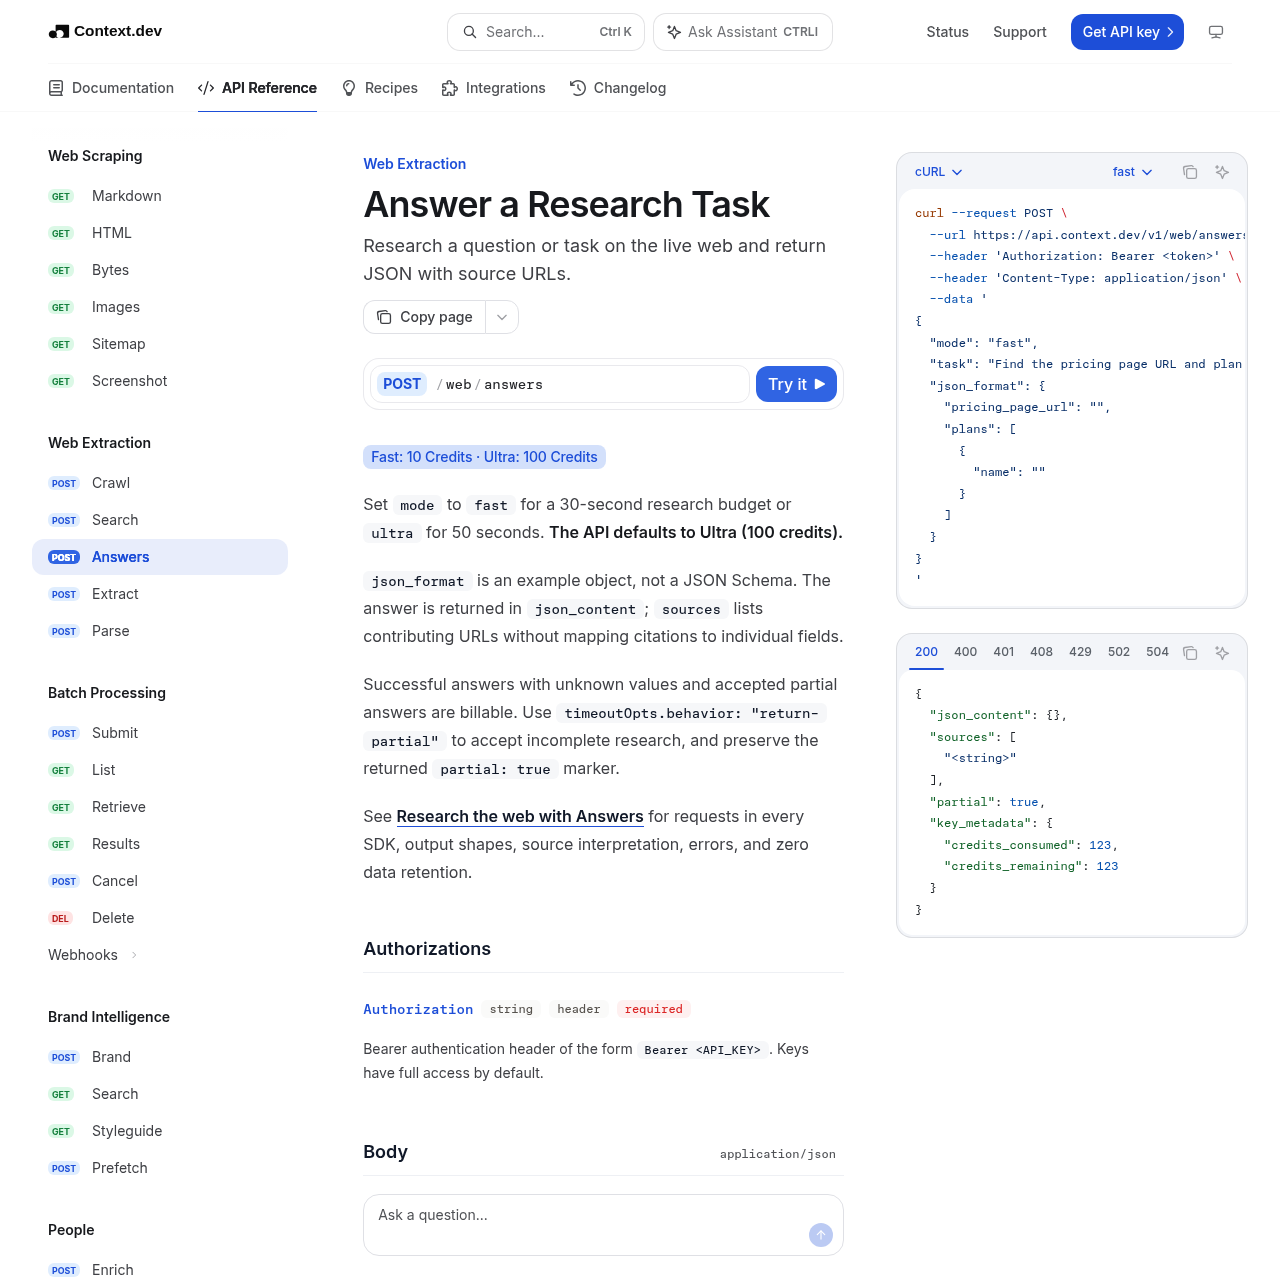
Answers by Context.dev 是一款专门用于在实时网络上执行自然语言调研任务的网络提取 API,能够将调研结果整理为结构化的 JSON 输出。用户只需提供自然语言提示词以及可选的模板对象,即可设定所需的输出层级结构、键名以及预期的数值类型。
该服务支持 fast 与 ultra 两种调研模式并具有不同的时间预算分配,能够按首次发现顺序列出参考来源 URL,同时提供零数据保留(Zero Data Retention)、用量标记以及超时处理等可选配置,以便在到达截止时间时返回部分已收集的数据。
有官方来源支持的使用场景
根据自然语言提示词从网络中提取特定事实与数据点,并注入预定义的 JSON 模板中。
引导调研代理首先深入检查特定网站,随后再将搜索范围扩大到更广泛的互联网。
Answers by Context.dev 采用示例 JSON 对象而非正式的模式(Schema)定义来塑造输出结果。该服务会严格遵循模板中提供的字段键与数据类型,将未知值填充为 null,并允许空数组容纳任意格式的 JSON 项。
当调研任务必须在严格的时间限制内完成时,可以通过配置超时选项来接受不完整的结果,而不是让请求直接报错失败。在这一配置下,响应会将 partial 标识标记为 true,并完整呈现截止时间前已收集到的全部数据。
用自己的素材和工作流完成验证
核对了哪些信息以及核对时间
基于已核对产品资料的回答
该 API 提供两种调研模式:fast 模式采用较小的模型并配备 30 秒的运行时间预算;ultra 模式则使用更深度的推理能力,配备 50 秒的预算,并且是系统的默认选项。
响应结构是通过在 json_format 字段中提供包含占位符值的示例对象来定义的,该机制会严格保留用户指定的字段键名以及对应的数据类型。
不会,所有提供参考的 URL 都会按照首次发现的顺序统一收录在单一的 sources 数组中返回,而不会将单条引用直接映射到特定的 JSON 字段上。
只需在纯文本任务提示词中直接指明域名,代理就会在启动更大范围的网络搜索之前,优先阅读并分析该指定站点的具体内容。
将 zdr 参数设置为 enabled 后,请求将直接绕过共享缓存,在持久化保留的日志中完全忽略请求与响应的内容,并会自动跳过资产文件的上传处理。