
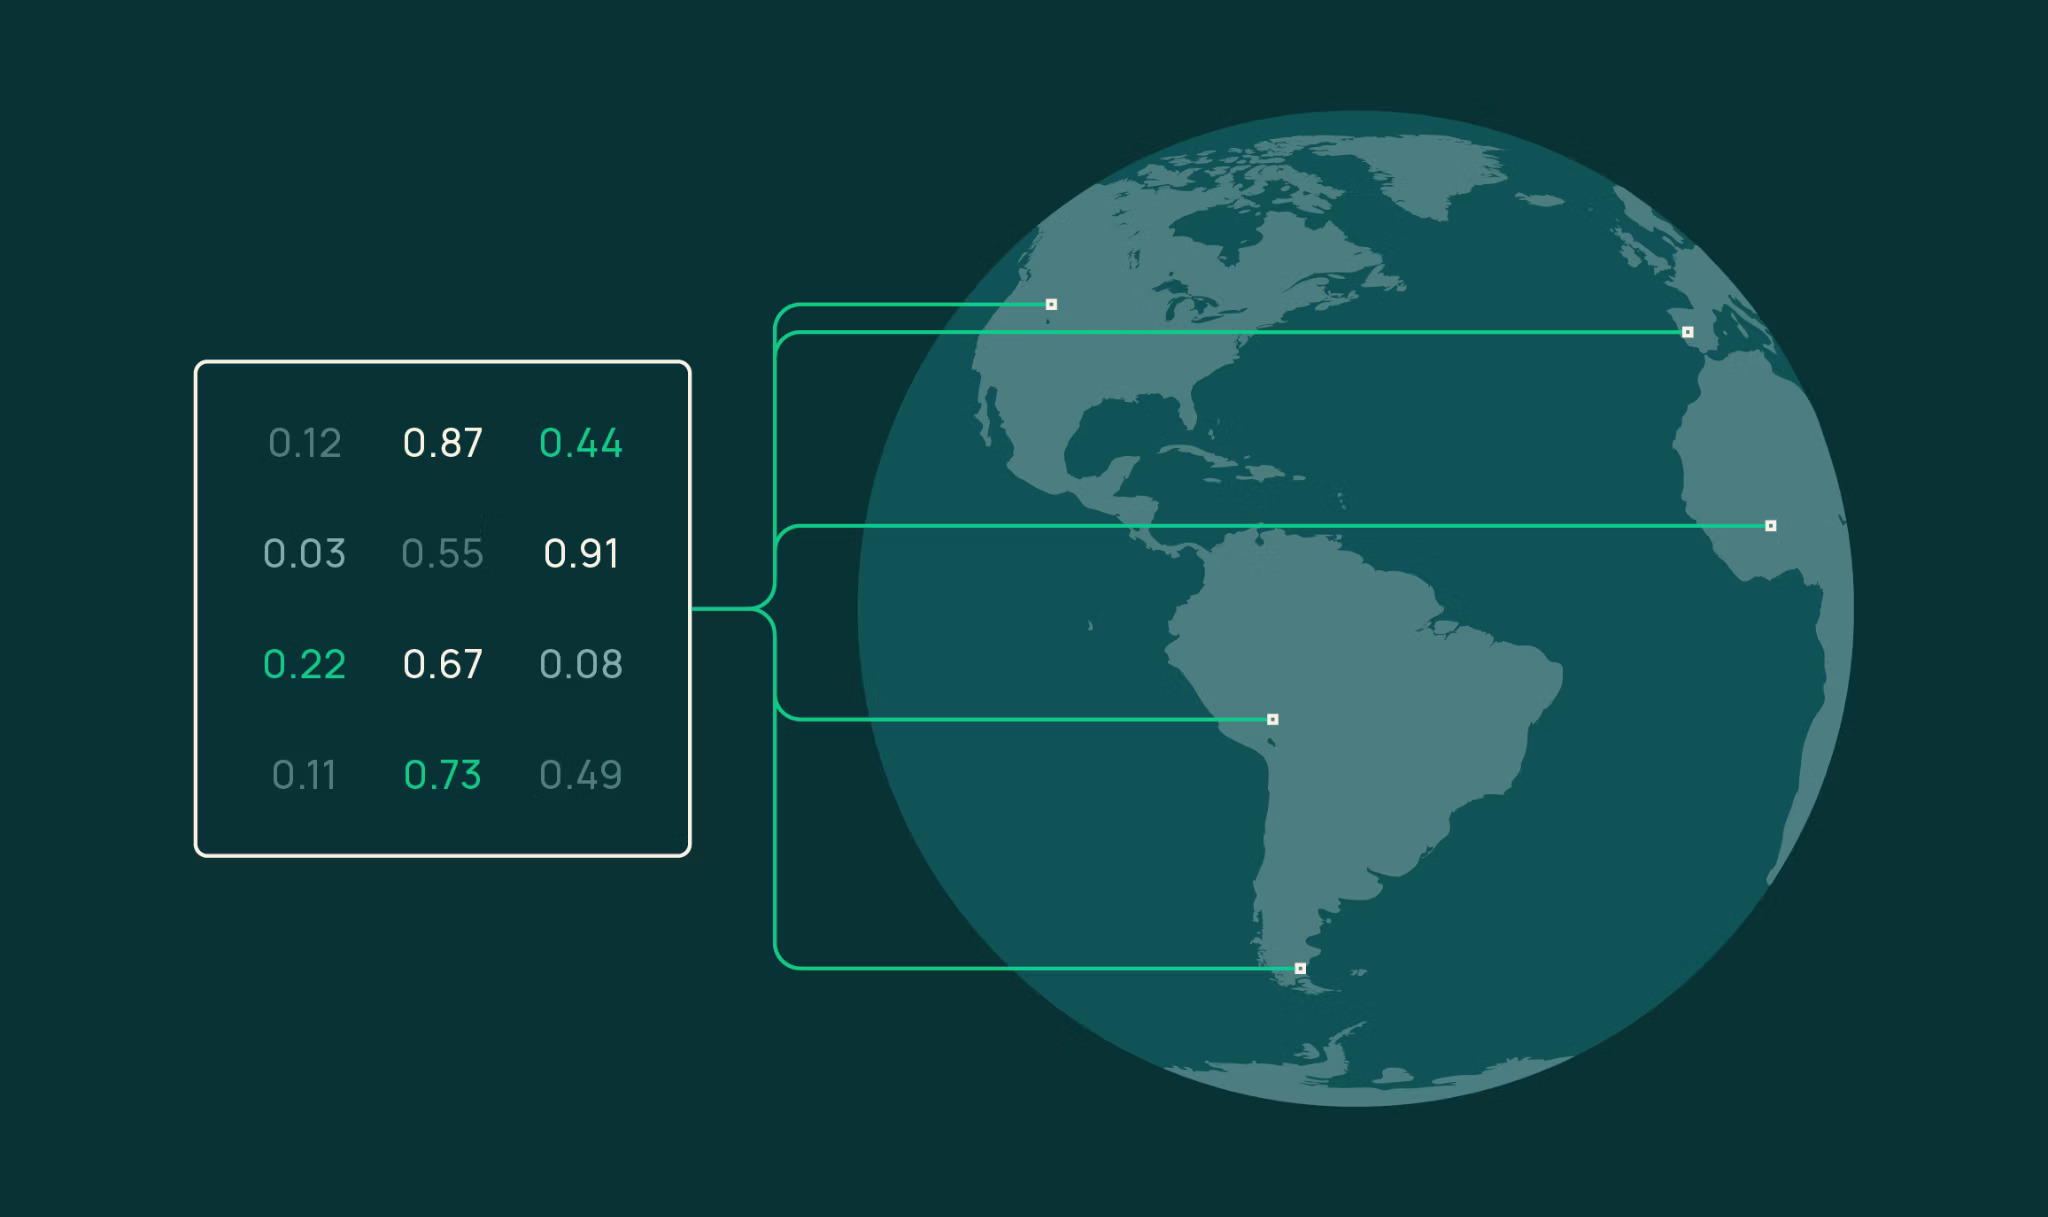
OlmoEarth Embeddings: Benutzerdefinierte Exporte aus dem OlmoEarth Studio für die Downstream-Analyse
Mit der Einführung der OlmoEarth Embeddings erweitert das OlmoEarth Studio seine Funktionalität um eine wesentliche Komponente für die wissenschaftliche Datenanalyse. Die neue Funktion ermöglicht es Nutzern, maßgeschneiderte Embeddings direkt zu exportieren, um sie für weiterführende Downstream-Analysen zu verwenden. Diese Ankündigung, die über den Hugging Face Blog veröffentlicht wurde, adressiert den Bedarf an flexiblen Datenrepräsentationen innerhalb der OlmoEarth-Umgebung. Durch die Bereitstellung dieser spezialisierten Exporte wird die Lücke zwischen der Modellinteraktion im Studio und der externen statistischen Auswertung geschlossen. Dies stellt einen wichtigen Fortschritt für Forscher dar, die auf präzise KI-gestützte Repräsentationen angewiesen sind, um komplexe Zusammenhänge in ihren spezifischen Fachgebieten zu untersuchen.
Die wichtigsten Punkte
- Einführung von OlmoEarth Embeddings: Eine neue Funktion zur Generierung und Nutzung spezialisierter Datenrepräsentationen.
- Benutzerdefinierte Exporte: Nutzer können Embeddings direkt aus dem OlmoEarth Studio für eigene Zwecke extrahieren.
- Fokus auf Downstream-Analyse: Die Exporte sind gezielt für die weiterführende Verarbeitung und statistische Auswertung außerhalb der Primärplattform konzipiert.
- Integration in das OlmoEarth-Ökosystem: Die Funktion erweitert das bestehende OlmoEarth Studio um eine wichtige Schnittstelle für Entwickler und Wissenschaftler.
Analyse
Erweiterung des OlmoEarth Studio
Die Ankündigung der OlmoEarth Embeddings markiert einen signifikanten Ausbau des OlmoEarth Studio. Bisher konzentrierten sich viele Plattformen dieser Art primär auf die Visualisierung oder die direkte Interaktion mit Modellen. Durch die Implementierung einer Exportfunktion für benutzerdefinierte Embeddings transformiert sich das OlmoEarth Studio von einer reinen Interaktionsplattform zu einem vollwertigen Werkzeug für die Datenvorbereitung.
Embeddings sind im Kontext der künstlichen Intelligenz hochdimensionale Vektoren, die Informationen in einer für Maschinen verarbeitbaren Form kodieren. Dass diese nun „custom“, also benutzerdefiniert, exportiert werden können, deutet darauf hin, dass Nutzer spezifische Parameter oder Datensätze wählen können, um genau die Repräsentationen zu erhalten, die für ihre individuellen Forschungsfragen relevant sind. Dies erhöht die Granularität der Arbeit mit OlmoEarth-Modellen erheblich.
Optimierung für die Downstream-Analyse
Ein zentraler Aspekt der Neuerung ist die Ausrichtung auf die sogenannte Downstream-Analyse. In der KI-Forschung bezeichnet dies alle Prozesse, die nach der initialen Modellierung oder Datengenerierung stattfinden – etwa Klassifizierungen, Clustering oder prädiktive Analysen in externen Softwareumgebungen.
Indem OlmoEarth den Export dieser Embeddings vereinfacht, wird der Workflow für Datenwissenschaftler gestrafft. Anstatt komplexe Pipelines aufbauen zu müssen, um Repräsentationen aus den Modellen zu extrahieren, bietet das OlmoEarth Studio nun einen direkten Weg. Dies ist besonders wertvoll für interdisziplinäre Teams, die KI-Modelle als Werkzeug für Fachbereiche wie Geowissenschaften oder Umweltforschung nutzen, wo die eigentliche Analyse oft in spezialisierten statistischen Programmen erfolgt.
Bedeutung für die KI-Branche
Die Veröffentlichung der OlmoEarth Embeddings unterstreicht einen Trend in der KI-Branche: die Demokratisierung des Zugangs zu tiefen Modellschichten. Während viele kommerzielle Anbieter ihre Embeddings hinter geschlossenen APIs verbergen, deutet die Bereitstellung über das OlmoEarth-Ökosystem (oft assoziiert mit dem Allen Institute for AI) auf einen offeneren, wissenschaftsorientierten Ansatz hin.
Für die Branche bedeutet dies eine verstärkte Interoperabilität. Wenn hochwertige Embeddings leicht zugänglich und exportierbar sind, können sie als Grundlage für eine Vielzahl von spezialisierten Anwendungen dienen, ohne dass jedes Mal ein komplettes Modell neu trainiert werden muss. Dies spart Ressourcen und beschleunigt den Innovationszyklus in der angewandten KI-Forschung, insbesondere in Bereichen, die komplexe räumliche oder zeitliche Daten verarbeiten, wie es der Name „OlmoEarth“ nahelegt.
Häufig gestellte Fragen
Was ist der Hauptvorteil der OlmoEarth Embeddings?
Der Hauptvorteil liegt in der Möglichkeit, maßgeschneiderte Vektorrepräsentationen direkt aus dem OlmoEarth Studio zu exportieren. Dies ermöglicht eine nahtlose Integration von KI-generierten Daten in externe Analyse-Tools für spezifische Forschungszwecke.
Für wen ist die Exportfunktion im OlmoEarth Studio gedacht?
Die Funktion richtet sich primär an Datenwissenschaftler, Forscher und Entwickler, die über die reine Modellinteraktion hinausgehen und tiefergehende statistische oder analytische Untersuchungen (Downstream-Analysen) durchführen möchten.
Wo wurden die OlmoEarth Embeddings angekündigt?
Die offizielle Ankündigung erfolgte über den Hugging Face Blog, eine zentrale Plattform für die Veröffentlichung von KI-Modellen und Forschungsergebnissen.

