
Effiziente Robotik-Workflows: Aufzeichnen, Trainieren und Bereitstellen mit Strands Agents, LeRobot und Hugging Face Storage Buckets
Hugging Face präsentiert eine integrierte Lösung für die Robotik-Entwicklung, die den gesamten Prozess von der Datenerfassung bis zur Implementierung vereinfacht. Durch die Kombination von Strands Agents, der LeRobot-Bibliothek und Hugging Face Storage Buckets wird ein nahtloser Workflow geschaffen. Entwickler können nun Roboterdaten aufzeichnen, KI-Modelle trainieren und diese direkt bereitstellen – alles innerhalb eines zentralen Ökosystems. Dieser Ansatz nutzt eine effiziente Daten-Streaming-Schleife, um die Handhabung großer Datenmengen in der Robotik zu optimieren. Die Integration zielt darauf ab, die technische Komplexität zu reduzieren und die Entwicklungszyklen für KI-gesteuerte Agenten erheblich zu beschleunigen, indem alle notwendigen Werkzeuge an einem Ort konsolidiert werden.
Die wichtigsten Punkte
- Zentralisierte Plattform: Aufzeichnen, Trainieren und Bereitstellen von Robotik-KI erfolgt nun an einem einzigen Ort.
- Nahtlose Integration: Strands Agents und LeRobot arbeiten zusammen, um den Workflow von der Erfassung bis zur Anwendung zu schließen.
- Optimiertes Datenmanagement: Hugging Face Storage Buckets ermöglichen eine effiziente Daten-Streaming-Schleife für große Robotik-Datensätze.
- End-to-End-Lösung: Der gesamte Entwicklungszyklus wird in einer konsistenten Umgebung abgebildet.
Analyse
Ein einheitlicher Workflow für die Robotik-Entwicklung
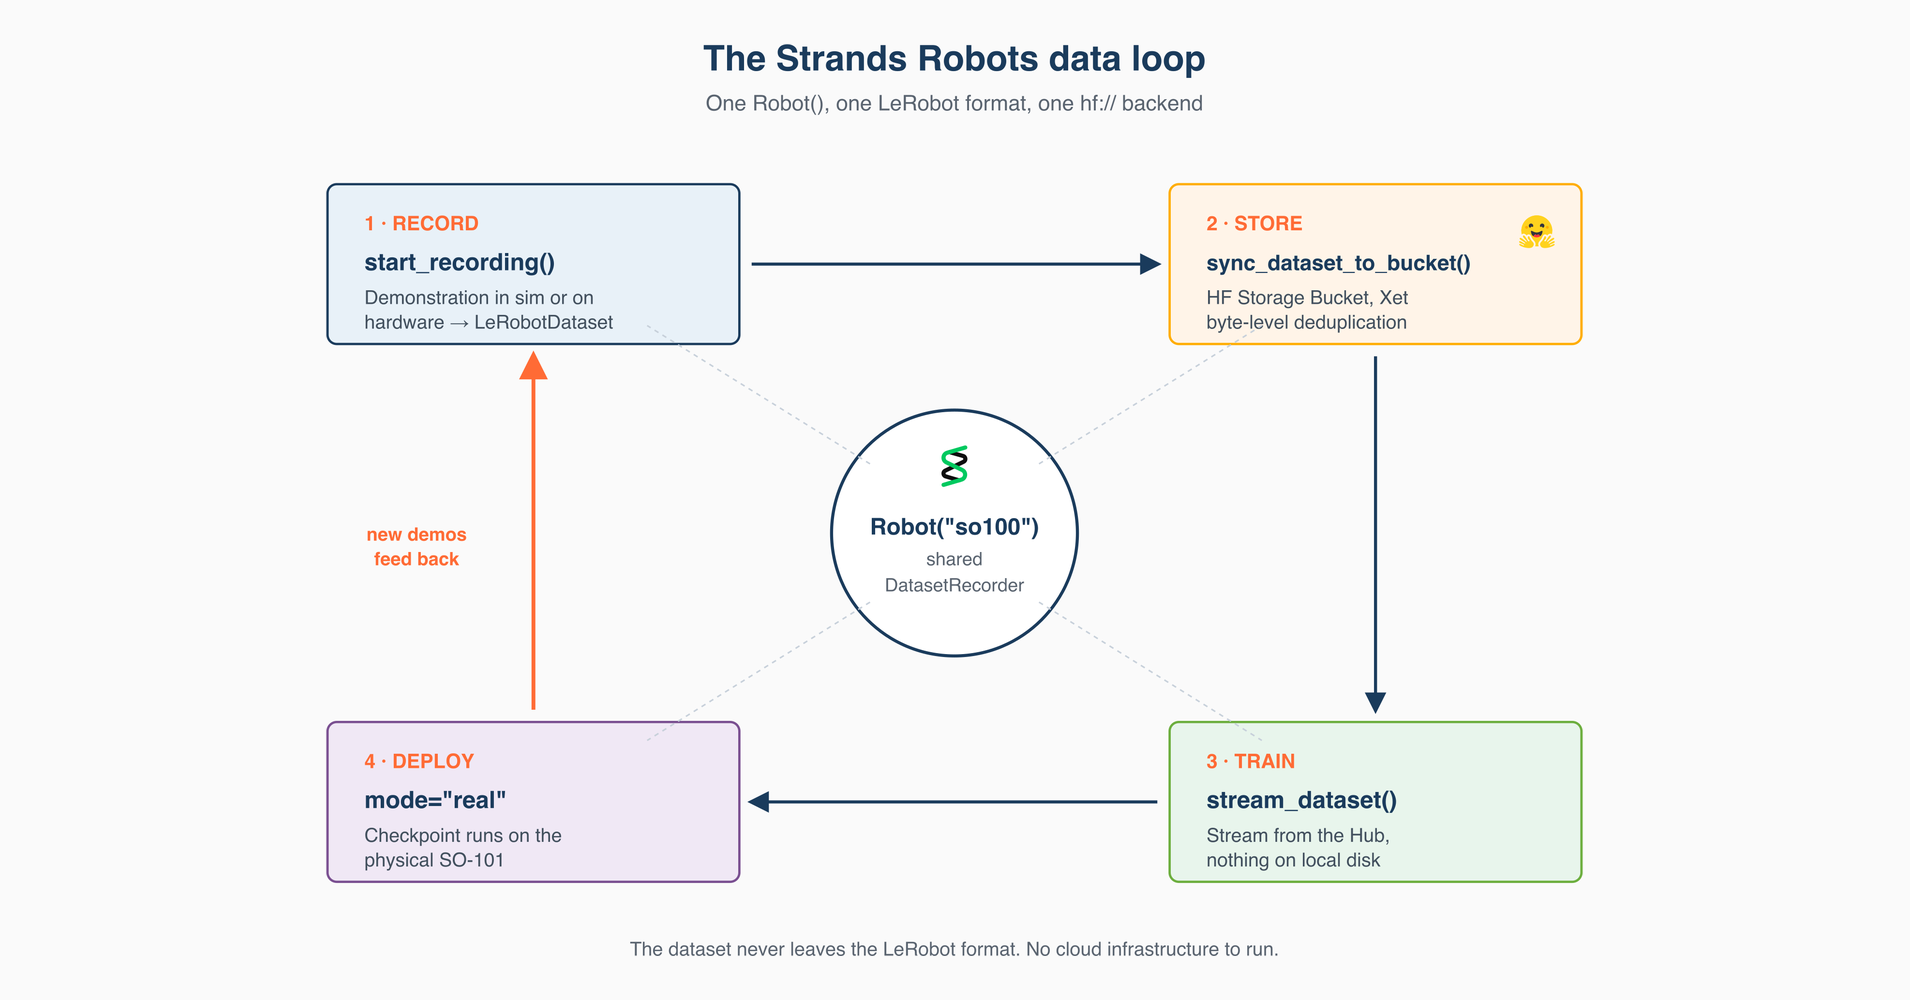
Die aktuelle Entwicklung bei Hugging Face adressiert eine der größten Herausforderungen in der KI-Robotik: die Fragmentierung der Werkzeuge. Bisher mussten Entwickler oft zwischen verschiedenen Systemen wechseln, um Daten von Robotern aufzuzeichnen, diese für das Training aufzubereiten und die fertigen Modelle schließlich wieder auf die Hardware zu bringen. Mit der Integration von Strands Agents, LeRobot und Hugging Face Storage Buckets wird dieser Prozess nun in einem geschlossenen Kreislauf („Streaming Data Loop“) zusammengeführt.
Der Prozess beginnt mit der Phase des Aufzeichnens (Record). Hierbei werden Interaktionsdaten und Sensordaten direkt erfasst. Durch die Einbindung von Strands Agents und der spezialisierten LeRobot-Bibliothek wird sichergestellt, dass die Daten in einem Format vorliegen, das unmittelbar für die nächste Phase nutzbar ist. Dies reduziert den Aufwand für die Datenbereinigung und -konvertierung erheblich.
Die Rolle der Storage Buckets und das Training
Im Zentrum dieses Workflows stehen die Hugging Face Storage Buckets. In der Robotik ist das Datenaufkommen durch hochauflösende Sensoren und kontinuierliche Streams enorm. Die Storage Buckets dienen als skalierbare Infrastruktur, um diese Datenmengen zu speichern und gleichzeitig eine performante Schnittstelle für das Training (Train) zu bieten.
Die „Streaming-Data-Loop“ sorgt dafür, dass die aufgezeichneten Informationen ohne große Latenz in den Trainingsprozess einfließen können. Dies ermöglicht schnellere Iterationszyklen, da Modelle auf Basis frisch gewonnener Daten zeitnah aktualisiert werden können. Sobald das Training abgeschlossen ist, erlaubt die Plattform die direkte Bereitstellung (Deploy) der Agenten, wodurch die Lücke zwischen Softwareentwicklung und physischer Anwendung geschlossen wird.
Bedeutung für die KI-Branche
Diese Entwicklung signalisiert einen Trend zur Professionalisierung und Standardisierung von Robotik-Workflows innerhalb der KI-Community. Indem Hugging Face eine End-to-End-Infrastruktur bereitstellt, wird die Barriere für den Einstieg in die KI-gestützte Robotik gesenkt. Unternehmen und Forscher müssen weniger Zeit in den Aufbau eigener Daten-Pipelines investieren und können sich stattdessen auf die Optimierung der Agenten-Logik konzentrieren. Die Konsolidierung dieser Funktionen auf einer Plattform könnte die Entwicklung autonomer Systeme beschleunigen und die Zusammenarbeit innerhalb der Open-Source-Robotik-Community durch standardisierte Speicher- und Trainingsmethoden stärken.
Häufig gestellte Fragen
Was ist der Vorteil der Integration von LeRobot in diesen Workflow?
LeRobot bietet spezialisierte Werkzeuge für die Robotik, die durch die Integration direkt auf die Cloud-Infrastruktur und die Speicherlösungen von Hugging Face zugreifen können. Dies vereinfacht den Übergang von der lokalen Datenerfassung zum Cloud-basierten Training.
Wie unterstützt die Daten-Streaming-Schleife die Entwicklung?
Die Streaming-Schleife ermöglicht es, Daten kontinuierlich von den Strands Agents in die Storage Buckets zu übertragen und für das Training bereitzustellen. Dies minimiert manuelle Datenübertragungen und beschleunigt den gesamten Entwicklungszyklus von der Aufnahme bis zum Deployment.
Warum sind Hugging Face Storage Buckets für dieses Szenario wichtig?
Robotik-Daten sind oft sehr umfangreich. Die Storage Buckets bieten die notwendige Skalierbarkeit und Integration in das Hugging Face Ökosystem, um diese Daten sicher zu speichern und performant für KI-Trainingsprozesse verfügbar zu machen.

