
Warum lokale LLMs oft schlechter abschneiden als erwartet: Eine technische Analyse der Implementierungshürden
Der Artikel untersucht die Diskrepanz zwischen den beeindruckenden Benchmark-Versprechen moderner Sprachmodelle (LLMs) und ihrer tatsächlichen Leistung in lokalen Umgebungen. Oftmals enttäuschen lokal ausgeführte Modelle, da sie hinter den sogenannten „Referenzimplementierungen“ der Entwicklerlabore zurückbleiben. Die Ursachen hierfür sind vielfältig und technischer Natur: Sie reichen von der Verwendung quantisierter Modellversionen bis hin zu tiefgreifenden Unterschieden in der Hardware-Architektur. Insbesondere variierende GPU-Generationen und deren spezifische Befehlssätze führen dazu, dass mathematische Berechnungen zur Token-Generierung anders ausgeführt werden als in der optimierten Laborumgebung. Der Beitrag verdeutlicht, dass die lokale Inferenz mit spezifischen Gefahren verbunden ist, die die wahrgenommene Intelligenz eines Modells massiv beeinträchtigen können.
Die wichtigsten Punkte
- Diskrepanz zur Referenz: Lokale Implementierungen erreichen selten die Qualität der originalen Referenzimplementierungen der Forschungslabore.
- Einfluss der Quantisierung: Die Nutzung verkleinerter Modellversionen (z. B. GGUF) führt oft zu einem spürbaren Qualitätsverlust gegenüber dem Original.
- Hardware-Varianz: Unterschiedliche GPU-Generationen und deren spezifische Befehlssätze beeinflussen die mathematische Präzision der Token-Berechnung.
- Software-Hürden: Die Inferenz-Software und die spezifische Konfiguration im Home-Lab unterscheiden sich fundamental von den optimierten Systemen der Hersteller.
- Individuelle Performance: Jede Hardware-Software-Kombination berechnet das nächste Token potenziell anders, was zu inkonsistenten Ergebnissen führt.
Analyse
Die Kluft zwischen Labor und Home-Lab
Ein zentrales Problem bei der Nutzung lokaler Sprachmodelle ist der Vergleich mit der sogenannten Referenzimplementierung. Diese beschreibt die Umgebung des Labors, das das Modell ursprünglich veröffentlicht hat. Diese Labore nutzen erstklassige Hardware und spezifische Software-Stacks, um ihre Benchmark-Ergebnisse zu erzielen.
Wenn Anwender ein Modell herunterladen, nutzen sie oft nicht das Original, sondern eine quantisierte Form (wie beispielsweise 2.58-bit GGUF in Ollama). Diese Komprimierung ist zwar notwendig, um die Modelle auf handelsüblicher Hardware lauffähig zu machen, sie stellt jedoch bereits die erste Hürde für die Modellqualität dar. Der Autor weist darauf hin, dass viele Nutzer enttäuscht sind, wenn ein als „revolutionär“ angepriesenes Modell in der eigenen Umgebung plötzlich unzureichende Ergebnisse liefert.
Technische Inferenz-Gefahren und Hardware-Einflüsse
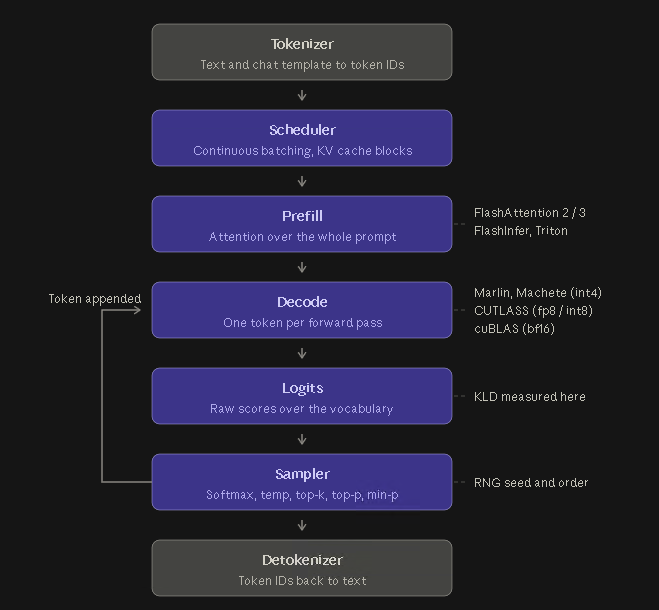
Die Analyse geht tief auf die technischen Ursachen für die geminderte Leistung ein. Ein oft übersehener Faktor ist die Hardware-Inkonsistenz. Im Gegensatz zu den homogenen Clustern der Entwickler mischen Heimanwender oft verschiedene GPU-Generationen.
Diese Chips verfügen über unterschiedliche Befehlssätze, die die Mathematik hinter der Token-Generierung auf verschiedene Weise implementieren und ausführen. Selbst wenn zwei Nutzer exakt dieselben Modellgewichte verwenden, können ihre Systeme das „nächste Token“ aufgrund dieser Hardware-Unterschiede unterschiedlich berechnen. Dies führt dazu, dass die lokale Implementierung im Vergleich zum Idealzustand des Herstellers schlechter abschneidet. Der Autor betont, dass nahezu jede lokale Instanz heute von diesen Unterschieden betroffen ist, was die Vergleichbarkeit von Modellen erschwert.
Bedeutung für die KI-Branche
Diese Erkenntnisse haben weitreichende Folgen für die Bewertung von KI-Modellen. Sie zeigen, dass Benchmarks nur bedingt aussagekräftig für den Endanwender sind, da die Inferenz-Umgebung einen entscheidenden Einfluss auf die Modellintelligenz hat. Für die Branche bedeutet dies, dass die Optimierung von Software-Stacks und die Standardisierung der Inferenzprozesse ebenso wichtig sind wie die Entwicklung der Modelle selbst. Solange die Hardware-Landschaft so fragmentiert bleibt, wird die „wahrgenommene Intelligenz“ lokaler LLMs weiterhin stark schwanken und oft hinter den theoretischen Möglichkeiten zurückbleiben.
Häufig gestellte Fragen
Warum fühlt sich mein lokales Modell „dümmer“ an als die Online-Version des Herstellers?
Dies liegt meist an der Differenz zwischen Ihrer lokalen Umgebung und der Referenzimplementierung des Herstellers. Faktoren wie Quantisierung (Komprimierung des Modells), unterschiedliche Software-Engines und die spezifische Hardware-Konfiguration Ihres PCs führen dazu, dass das Modell nicht mit der vollen Präzision arbeitet, die in den offiziellen Benchmarks erreicht wurde.
Welchen Einfluss hat meine Grafikkarte (GPU) auf die Qualität der Antworten?
Unterschiedliche GPU-Generationen nutzen verschiedene Befehlssätze, um die notwendigen Berechnungen für die KI durchzuführen. Da diese Berechnungen bestimmen, welches Wort (Token) als nächstes generiert wird, können Hardware-Unterschiede dazu führen, dass die Logik der Antwort geringfügig von der Idealversion abweicht. Besonders das Mischen verschiedener GPU-Typen kann die Konsistenz der Ergebnisse beeinflussen.


