
Xiaomi Xring O3: Neuer Prozessor erreicht Apple-Niveau bei Single-Core-Leistung und setzt neue Maßstäbe im Multi-Threading
Xiaomi hat mit dem Xring O3 einen neuen Prozessor vorgestellt, der die Leistungslandschaft im Mobilbereich grundlegend verändern könnte. In aktuellen Benchmarks erreicht der Chip im Single-Core-Test von Geekbench 3.945 Punkte und zieht damit mit den Kernen von Apple gleich. Besonders beeindruckend ist die Multi-Core-Performance, die mit 15.221 Punkten einen neuen Bestwert markiert. Der Prozessor basiert auf den leistungsstarken C1-Ultra-Kernen und zeichnet sich durch eine extrem breite Architektur mit 21 Execution Ports sowie einen massiven Cache von 44 MB aus. Damit übertrifft der Xring O3 sogar viele aktuelle Laptop-CPUs von Intel. Durch die Integration von SME2 und SVE2 ist der Chip zudem speziell für KI-Beschleunigung und parallele Datenverarbeitung optimiert, was einen deutlichen Trend zu massiv parallelen Recheneinheiten in der ARM-Architektur unterstreicht.
Die wichtigsten Punkte
- Herausragende Benchmark-Ergebnisse: Der Xiaomi Xring O3 erzielt 3.945 Punkte im Geekbench Single-Core und einen Rekordwert von 15.221 Punkten im Multi-Core-Test.
- Leistungsstarke C1-Ultra-Kerne: Die Architektur nutzt C1-Ultra-Kerne, die über 21 Execution Ports verfügen, was die Kapazität vieler Desktop-Prozessoren von Intel oder AMD übersteigt.
- Massiver Cache-Speicher: Mit insgesamt 44 MB Cache bietet der Chip mehr Zwischenspeicher als die meisten gängigen Laptop-CPUs.
- Fortschrittliche Befehlssatzerweiterungen: Unterstützung für SME2 (Scalable Matrix Extension 2) zur KI-Beschleunigung und SVE2 für verbesserte Datenparallelität (SIMD).
- Trend zur massiven Parallelität: Die Entwicklung zeigt eine klare Richtung hin zu mehr Ausführungseinheiten und größeren Cache-Strukturen, um die Rechenleistung pro Taktzyklus zu maximieren.
Analyse
Architektur und Rechenleistung der C1-Ultra-Kerne
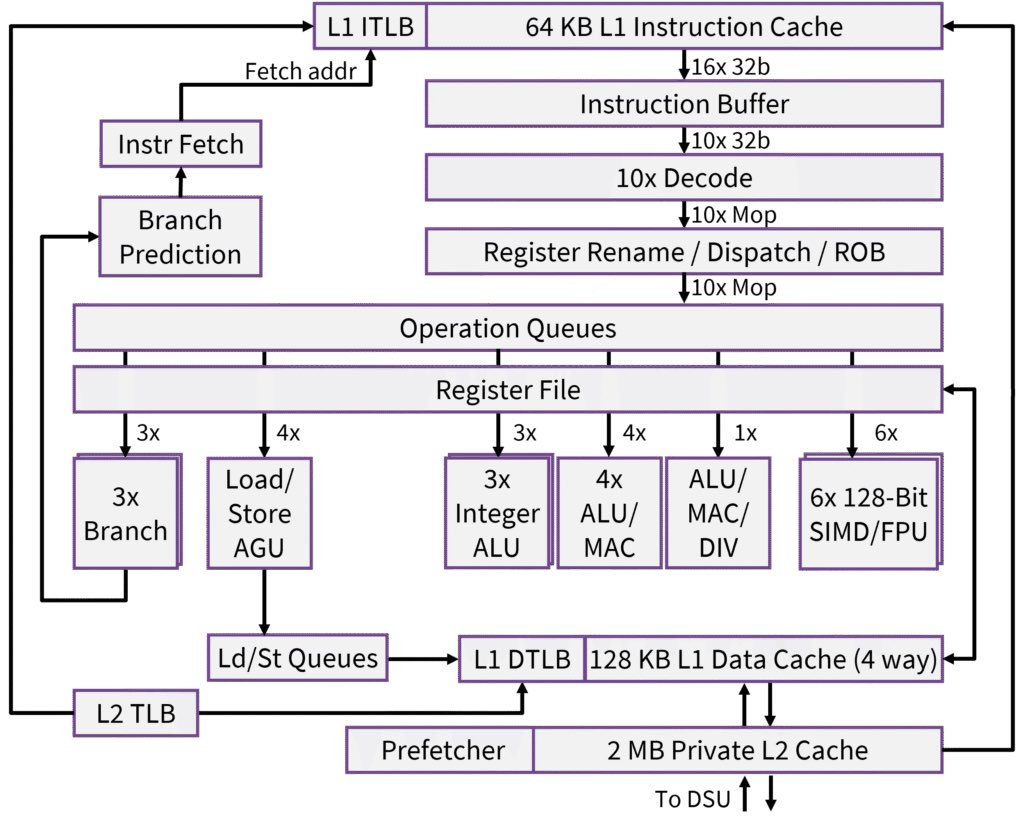
Die technische Basis des Xiaomi Xring O3 bilden die sogenannten C1-Ultra-Kerne. Diese Kerne zeichnen sich durch eine außergewöhnliche Breite in der Ausführungslogik aus. Mit insgesamt 21 Execution Ports ist der Prozessor in der Lage, eine enorme Anzahl an Operationen simultan zu verarbeiten. Zum Vergleich: Diese Anzahl an Ports übertrifft das, was derzeit in gängigen Intel- oder AMD-Prozessoren zu finden ist.
Besonders hervorzuheben ist die Konfiguration der SIMD-Einheiten (Single Instruction, Multiple Data). Der Xring O3 verfügt über sechs Ports, die 128-Bit-SIMD-Operationen unterstützen. Während AMDs Zen 5 Architektur mit 4x512-Bit-Einheiten in der Spitze noch einen Vorteil bei der reinen Bit-Breite hat, stellt die Lösung von Xiaomi mit 6x128-Bit eine der leistungsfähigsten Implementierungen innerhalb der ARM-Welt dar. Diese Architektur ermöglicht es, pro Taktzyklus eine Vielzahl unabhängiger Additionen und Multiplikationen durchzuführen, was die Effizienz bei komplexen Rechenaufgaben massiv steigert.
Cache-Hierarchie und Speicherdesign
Ein entscheidender Faktor für die hohe Performance des Xring O3 ist das Design des Cache-Speichers. Der Chip verfügt über insgesamt 44 MB Cache. Dieser Wert ist für einen mobilen Prozessor untypisch hoch und übertrifft sogar die Spezifikationen vieler aktueller Laptop-CPUs, insbesondere jener von Intel.
In der modernen Prozessorarchitektur ist der Cache der Ort, an dem ein Großteil der Transistoren zum Einsatz kommt. Ein größerer Cache reduziert die Notwendigkeit, auf den langsameren Hauptspeicher zuzugreifen, was besonders bei datenintensiven Anwendungen zu einem erheblichen Geschwindigkeitsvorteil führt. Xiaomi nutzt diesen Ansatz konsequent, um die Lücke zwischen mobilen Endgeräten und traditionellen Computern weiter zu schließen.
Technologische Trends und KI-Optimierung
Der Xring O3 ist nicht nur auf allgemeine Rechenleistung ausgelegt, sondern adressiert durch spezifische Erweiterungen auch moderne Anforderungen wie Künstliche Intelligenz. Durch die Unterstützung von SME2 (Scalable Matrix Extension 2) bietet der Chip eine dedizierte Beschleunigung für Matrix-Berechnungen, die das Rückgrat vieler KI-Anwendungen bilden.
Zusätzlich sorgt SVE2 (Scalable Vector Extension 2) für eine verbesserte Datenparallelität. Diese Kombination verdeutlicht einen klaren Trend in der Branche: Prozessoren werden zunehmend darauf optimiert, massiv parallele Aufgaben effizient zu bewältigen. Die Erhöhung der Anzahl der Recheneinheiten und die Erweiterung der SIMD-Fähigkeiten sind die primären Treiber für die Leistungssteigerungen, die wir aktuell beobachten.
Bedeutung für die KI-Branche
Die Einführung des Xring O3 signalisiert einen Wendepunkt für die Hardware-Unterstützung von KI-Anwendungen in mobilen Geräten. Durch die Integration von SME2 wird deutlich, dass Xiaomi die Matrix-Beschleunigung direkt in den CPU-Kern integriert, anstatt sich ausschließlich auf externe Beschleuniger zu verlassen. Dies ermöglicht eine schnellere und effizientere Ausführung von KI-Modellen direkt auf dem Gerät.
Die massive Parallelität der 21 Execution Ports und die sechs SIMD-Einheiten bieten zudem die notwendige Rohleistung, um komplexe Algorithmen der Datenverarbeitung parallel auszuführen. Für die Branche bedeutet dies, dass mobile Endgeräte zunehmend in der Lage sind, Aufgaben zu übernehmen, die bisher leistungsstarken Workstations vorbehalten waren. Der Fokus auf massiven Cache unterstützt zudem die Verarbeitung großer Datensätze, wie sie in der KI-Forschung und -Anwendung üblich sind.
Häufig gestellte Fragen
Wie schneidet der Xiaomi Xring O3 im Vergleich zu Apple-Prozessoren ab?
Gemäß den aktuellen Benchmark-Daten erreicht der Xring O3 im Single-Core-Test 3.945 Punkte und liegt damit etwa auf Augenhöhe mit den aktuellen Kernen von Apple. Im Multi-Core-Bereich ist der Xiaomi-Chip mit 15.221 Punkten jedoch deutlich schneller als die derzeitigen Vergleichswerte von Apple.
Was sind die technischen Besonderheiten der C1-Ultra-Kerne?
Die C1-Ultra-Kerne sind besonders „breit“ gebaut und verfügen über 21 Execution Ports. Sie unterstützen moderne Befehlssatzerweiterungen wie SME2 für Matrix- und KI-Berechnungen sowie SVE2 für parallele Datenverarbeitung. Dies macht sie extrem leistungsfähig bei der Bewältigung vieler gleichzeitiger Rechenoperationen.
Warum ist der 44 MB große Cache so wichtig?
Der Cache dient als extrem schneller Zwischenspeicher für den Prozessor. Mit 44 MB bietet der Xring O3 mehr Speicherplatz als viele Laptop-CPUs. Dies sorgt dafür, dass Daten schneller bereitgestellt werden können und der Prozessor seltener auf den langsameren Arbeitsspeicher warten muss, was die Gesamtgeschwindigkeit erheblich steigert.


