
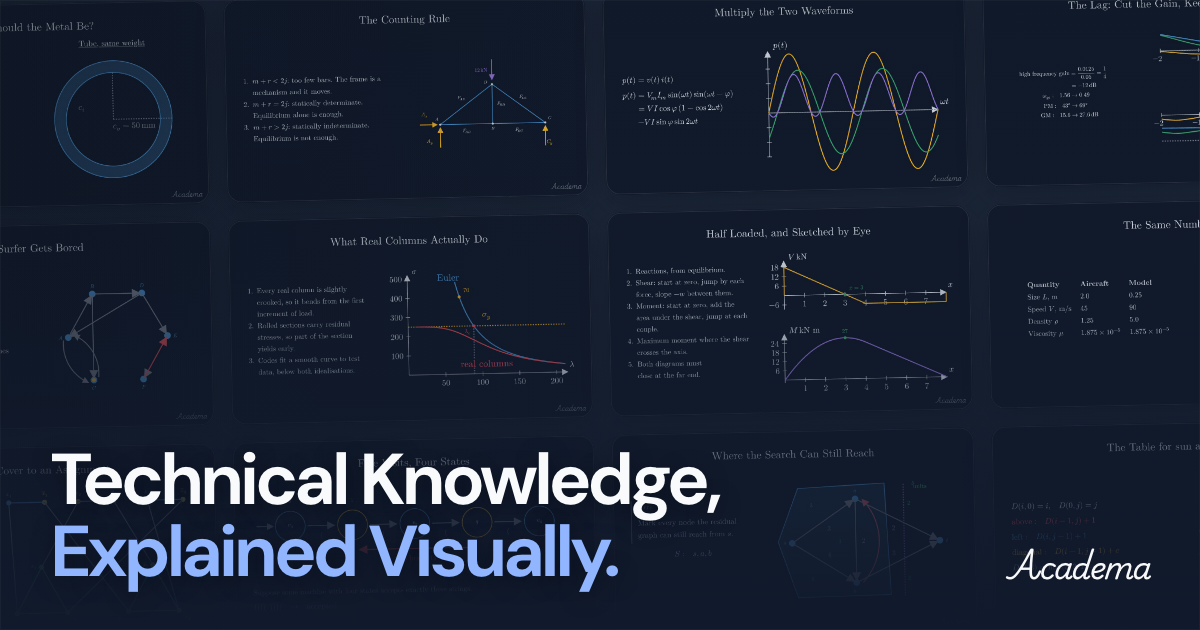
Academa: Wie KI-generierte STEM-Vorlesungen durch den Video-as-Code-Ansatz die Online-Bildung grundlegend transformieren
Academa stellt ein neues Paradigma für die Online-STEM-Bildung vor, indem es Vorlesungsvideos wie Software-Code behandelt. Traditionelle Bildungsvideos von Plattformen wie Khan Academy oder Coursera sind in der Produktion starr und nach der Fertigstellung kaum zu korrigieren. Academa löst dieses Problem durch einen innovativen „Video-as-Code“-Ansatz: Dozenten definieren Lehrinhalte durch Aktionen wie Sprechen, Zeichnen oder Schreiben in Form von Quellcode. Ein spezieller Compiler wandelt diesen Code unter Einsatz von Text-to-Speech und Computergrafik in hochwertige Videos um. Dieser Prozess ermöglicht es, Fehler einfach im Code zu beheben und neue Versionen zu veröffentlichen, ähnlich wie in der Softwareentwicklung. Durch die Integration von Large Language Models (LLMs), die bereits im Bereich Software Engineering signifikante Fortschritte erzielt haben, wird die Erstellung komplexer technischer Lerninhalte automatisiert und langfristig wartbar.
Die wichtigsten Punkte
- Video-as-Code Paradigma: Vorlesungsvideos werden nicht mehr klassisch aufgenommen, sondern als wartbarer Quellcode geschrieben.
- Effiziente Fehlerbehebung: Korrekturen an Lerninhalten können wie Bugfixes in der Softwareentwicklung durchgeführt werden, ohne das gesamte Video neu produzieren zu müssen.
- Automatisierte Produktion: Ein Compiler nutzt Text-to-Speech (TTS) und Computergrafiken, um aus dem Code visuelle und auditive Lehrinhalte zu generieren.
- Synergie mit LLMs: Die Plattform nutzt die Stärken von Large Language Models in der Code-Generierung, um die Erstellung von STEM-Inhalten zu skalieren.
- Abkehr vom starren Aufnahme-Modell: Academa bricht mit der traditionellen Methode, bei der Professoren vor einer Tafel gefilmt werden, zugunsten eines dynamischen, digitalen Formats.
Analyse
Das Problem der Starrheit in der Online-Bildung
Die aktuelle Landschaft der Online-STEM-Bildung (Science, Technology, Engineering, Mathematics) basiert primär auf einer digitalen Bibliothek von Vorlesungsvideos. Plattformen wie Khan Academy, Udemy oder das MIT OpenCourseWare folgen einem bewährten Modell: Ein Professor präsentiert Inhalte an einer Tafel, zeichnet Diagramme, schreibt Gleichungen auf und erklärt diese simultan. Diese Performance wird aufgezeichnet und ins Internet gestellt.
Obwohl dieses Modell den Zugang zu Bildung demokratisiert hat, weist es eine fundamentale Schwäche auf: die mangelnde Flexibilität. Die Produktion eines qualitativ hochwertigen Vorlesungsvideos ist ein extrem aufwendiger Prozess. Wenn ein Dozent zwei Wochen nach der Veröffentlichung einen Fehler in einer Gleichung oder einer Erklärung entdeckt, steht er vor einem Dilemma. Da das Video ein fertiges, statisches Endprodukt ist, kann der Fehler nicht einfach „gelöscht“ werden. In der Praxis bedeutet dies entweder, dass der Fehler im Video verbleibt oder dass der gesamte Produktionsprozess von vorne beginnen muss. Diese Ineffizienz behindert die kontinuierliche Verbesserung von Lehrmaterialien.
Video-as-Code: Die Lösung durch Software-Prinzipien
Academa verfolgt einen radikal neuen Ansatz, indem es die Prinzipien der Softwareentwicklung auf die Erstellung von Lehrvideos überträgt. Anstatt ein Video als unveränderliche Mediendatei zu betrachten, wird es als Quellcode definiert. Die Handlungen eines Lehrers – das Sprechen, das Zeichnen eines Quadrats, das Beschriften einer Achse oder das Aufschreiben einer Formel – werden in präzise Code-Befehle übersetzt.
Ein Beispiel für diesen Workflow verdeutlicht die Logik: Ein Befehl wie say "Look at this square." wird mit einer Aktion wie draw square kombiniert. Der entscheidende technologische Kern ist der Compiler. Dieser nimmt den geschriebenen Quellcode und transformiert ihn mithilfe von computergenerierten Grafiken und Text-to-Speech-Systemen in ein flüssiges Video.
Dieser Ansatz transformiert das Video in ein wartbares Gut. Wenn ein Fehler gefunden wird, muss nicht die Kamera neu positioniert werden; stattdessen wird die entsprechende Zeile im Code korrigiert und das Video neu „kompiliert“. Dies ermöglicht eine Iterationsgeschwindigkeit, die in der traditionellen Videoproduktion undenkbar wäre. Bildungsinhalte werden dadurch zu einer „lebenden“ Software, die über die Zeit verbessert und aktualisiert werden kann.
Die Rolle von LLMs in der Content-Erstellung
Die Einführung von Large Language Models (LLMs) verleiht dem Video-as-Code-Konzept eine zusätzliche Dimension. LLMs haben ihre bisher größte Wirkung im Bereich Software Engineering entfaltet, da sie exzellent darin sind, logischen und strukturierten Code zu generieren. Da Academa Vorlesungen in Code übersetzt, können LLMs direkt in den Erstellungsprozess integriert werden.
Anstatt dass ein Mensch jede Zeile des Vorlesungscodes manuell schreiben muss, können LLMs komplexe STEM-Konzepte in den entsprechenden Academa-Code übersetzen. Dies automatisiert nicht nur die Erstellung, sondern erlaubt es auch, komplexe mathematische und wissenschaftliche Zusammenhänge präzise und konsistent darzustellen. Die Verbindung von LLMs mit einem strukturierten Ausgabeformat wie dem von Academa löst eines der Hauptprobleme bei der Skalierung von qualitativ hochwertiger Online-Bildung.
Bedeutung für die KI-Branche
Die Entwicklung von Academa markiert einen wichtigen Schritt in der Evolution der KI-gestützten Content-Erstellung. Während sich viele KI-Tools auf die rein generative Erzeugung von Bildern oder Videos konzentrieren (oft mit dem Risiko von Halluzinationen oder mangelnder logischer Konsistenz), setzt Academa auf eine strukturierte Zwischenschicht: den Code.
Für die KI-Branche bedeutet dies, dass der Fokus sich von der rein visuellen Generierung hin zur logikbasierten Generierung verschiebt. In der STEM-Bildung ist Präzision unerlässlich. Durch den Umweg über Code stellt Academa sicher, dass die KI-Inhalte überprüfbar und editierbar bleiben. Dies könnte als Vorbild für andere Branchen dienen, in denen Faktenreue und Wartbarkeit wichtiger sind als rein ästhetische Videoeffekte. Zudem zeigt es, wie LLMs über das reine Chatten hinaus als produktive Werkzeuge in spezialisierten Compilern eingesetzt werden können, um komplexe Medienformate zu revolutionieren.
Häufig gestellte Fragen
Was ist der Hauptvorteil von „Video-as-Code“ gegenüber herkömmlichen Aufnahmen?
Der Hauptvorteil liegt in der Wartbarkeit und Editierbarkeit. Während herkömmliche Videos bei Fehlern komplett neu gedreht werden müssen, kann bei Video-as-Code einfach der Quellcode geändert und das Video neu generiert werden. Dies spart Zeit, Ressourcen und ermöglicht eine kontinuierliche Verbesserung der Inhalte.
Wie werden die visuellen und auditiven Elemente bei Academa erzeugt?
Academa nutzt einen Compiler, der den Quellcode verarbeitet. Für die Audiospur wird Text-to-Speech-Technologie verwendet, während die visuellen Elemente wie Gleichungen, Diagramme und Zeichnungen durch Computergrafiken erzeugt werden. Dies sorgt für ein sauberes, professionelles Erscheinungsbild, das einer Tafelpräsentation nachempfunden ist.
Warum sind LLMs für diesen Ansatz so wichtig?
LLMs sind besonders stark darin, Code zu schreiben und logische Strukturen zu verstehen. Da Academa Vorlesungen als Code definiert, können LLMs genutzt werden, um den Erstellungsprozess zu automatisieren. Sie können komplexe wissenschaftliche Erklärungen direkt in das ausführbare Format von Academa übersetzen, was die Produktion massiv beschleunigt.


