SLM-Inferenz für Such- und Empfehlungssysteme: Meituan stellt hochperformantes Framework für minimale Latenzen vor
Das Meituan-Technologieteam hat eine spezialisierte Inferenz-Engine für Small Language Models (SLM) mit 0,5 bis 1 Milliarde Parametern in Such- und Empfehlungsszenarien vorgestellt. Herkömmliche Inferenz-Engines für große Sprachmodelle sind selten für extrem strenge Online-Latenzanforderungen ausgelegt. Meituan begegnet dieser Herausforderung mit einer Neugestaltung des Ausführungspfads, die auf sogenannten beschränkten Generierungslasten basiert. Durch den Einsatz eines statischen gerichteten azyklischen Graphen (DAG), Offline-Kompilierung mittels PyTorch AOTInductor, Packed Prefill, anforderungsinternes KV-Sharing sowie selektives FP8 gelingt es, die durchschnittliche End-to-End-Latenz unter 20 Millisekunden zu drücken. Gleichzeitig erreicht das System eine effektive Model FLOPs Utilization (MFU) von 67 Prozent im Prefill-Only-Modus und steigert den Durchsatz im Vergleich zu SGLang um das Zehnfache. Die vorgestellte Architektur bietet eine wiederverwendbare technische Praxis für den industriellen Produktiveinsatz.
Die wichtigsten Punkte
- Spezialisierung auf SLM in Such- und Empfehlungssystemen: Meituan optimiert die produktive Bereitstellung von Small Language Models (0,5 bis 1 Milliarde Parameter) für Aufgaben wie Intent-Erkennung, Relevanzbewertung und generative Empfehlungen.
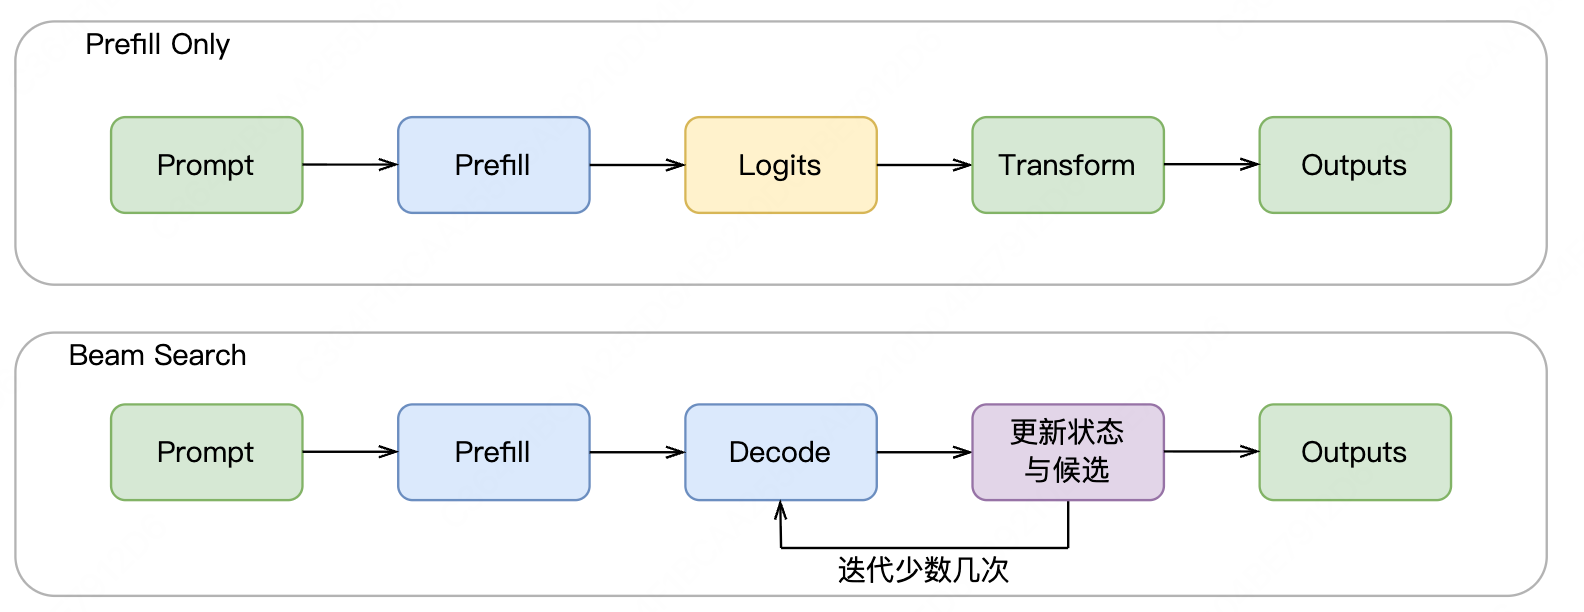
- Fokus auf beschränkte Generierungslasten: Anstelle offener Textgenerierung nutzt das System feste Obergrenzen für Dekodierschritte, darunter reine Prefill-Only-Aufgaben und strukturierte Beam-Search-Verfahren.
- Statische DAG-Architektur ohne Python-Overhead: Geschäftsanfragen werden als statischer Directed Acyclic Graph (DAG) modelliert, wobei die Rechenknoten per PyTorch AOTInductor kompiliert und von einer schlanken C++-Runtime ausgeführt werden.
- Signifikanter Leistungssprung: Die durchschnittliche End-to-End-Latenz sinkt unter 20 Millisekunden, die effektive MFU erreicht im Prefill-Only-Betrieb 67 Prozent und der Durchsatz steigt gegenüber SGLang um den Faktor 10.
Analyse
Die Grenzen generischer LLM-Engines im Suchkontext
In modernen Such- und Empfehlungsdiensten gewinnen kompakte Sprachmodelle (SLM) zunehmend an Relevanz, um Nutzerabsichten präzise zu verstehen oder Ranking-Signale generativ zu verarbeiten. Diese Modelle basieren typischerweise auf Decoder-only Transformer-Strukturen mit Next-Token Prediction. In der Praxis kollidiert ihr Einsatz jedoch mit extrem harten Latenzvorgaben des Online-Betriebs, in dem Millisekunden über die Auslieferung entscheiden.
Zu Beginn nutzte Meituan den Python-Backend des Triton Inference Servers in Kombination mit der Serving-Engine SGLang. Dieser Ansatz ermöglichte durch die Wiederverwendung bestehender Tokenizer- und Scheduling-Komponenten zwar schnelle Machbarkeitsnachweise, stieß bei der flächendeckenden Skalierung jedoch an wirtschaftliche und technische Grenzen. Generische LLM-Inferenzsysteme sind primär auf unvorhersehbare, offene Dialoge ausgelegt. In Such- und Empfehlungsszenarien treten jedoch vorwiegend klar abgegrenzte Lastmuster auf: der Prefill-Only-Modus, bei dem über den letzten Token oder nachgeschaltete MLP-Schichten direkt Scores abgeleitet werden (Null Dekodierschritte), sowie strukturierte Beam-Search-Verfahren mit fest definierten Breiten und maximalen Schritten. Das Meituan-Technologieteam definierte diese Workloads als „beschränkte Generierungslasten“ (Bounded Generation Workloads), deren Kontrollfluss und Ressourcenbedarf bereits vor dem Deployment exakt bestimmt werden können.
Architektur aus statischem DAG und AOTInductor-Kompilierung
Um die Latenzreserven voll auszuschöpfen, verwarf Meituan dynamische Scheduling-Schichten und implementierte ein Framework auf Basis statischer gerichteter azyklischer Graphen (DAG). Die vollständige Geschäftsanfrage bildet hierbei die einheitliche Grenze für Ausführung, End-to-End-Messung und Kapazitätsplanung. Die einzelnen Knoten des Graphen dienen gleichzeitig als exakte Modellkompilierungsgrenzen.
Auf der Rechenebene werden Modellknoten offline über den PyTorch AOTInductor (AOTI) kompiliert, wodurch C++-kompatible Binärartefakte entstehen. Zur Laufzeit übernimmt eine C++-Engine die Ablaufsteuerung, Ressourcenverwaltung und parallele Ausführung vollständig, wodurch der Interpreter-Overhead von Python vollständig eliminiert wird. Für vorgeschaltete Textverarbeitungen und Tensortransformationen kommen spezialisierte, systemeigene Graphknoten zum Einsatz.
Gezielte Kernel-Optimierungen und Verzicht auf Cross-Request-Caching
Ergänzend zur Graphenarchitektur setzt Meituans Engine auf ein Bündel systemspezifischer Rechenoptimierungen:
- Packed Prefill: Sequenzen werden ohne redundante Padding-Tokens kompakt zusammengefasst, sodass GPU-Ressourcen ausschließlich für tatsächliche Nutzdaten aufgewendet werden.
- Anforderungsinternes KV-Sharing: Bei parallelen Pfaden innerhalb derselben Geschäftsanfrage – etwa bei gemeinsamen Präfixen in Ranking-Kandidaten – wird der Key-Value-Cache wiederverwendet, um redundante Neuberechnungen zu vermeiden.
- Selektives FP8: Durch den gezielten Einsatz von FP8-Präzision bei matrixintensiven Operationen wird der Rechendurchsatz maximiert, ohne die Genauigkeit empfindlicher Modellteile zu beeinträchtigen.
- Verzicht auf globale Prefix-Caches: Da die Trefferquote von Präfixen über unterschiedliche Nutzeranfragen hinweg in Suchsystemen vernachlässigbar gering ausfällt, verzichtet das System bewusst auf aufwendige globale Cache-Verwaltungen und spart so Speicher- sowie Synchronisationsaufwand ein.
In der Praxis führt dieses Zusammenspiel dazu, dass das System selbst unter einer Obergrenze von 20 Millisekunden Latenz eine MFU von 67 Prozent erzielt und bestehende Standardlösungen um das Zehnfache im Durchsatz übertrifft.
Bedeutung für die KI-Branche
Die Veröffentlichung von Meituan unterstreicht einen wichtigen Paradigmenwechsel beim industriellen Einsatz von Sprachmodellen: Weg von universellen Allround-Engines hin zu aufgaben- und workloadspezifischen Inferenzarchitekturen. Während im Chatbot-Bereich lange Time-to-First-Token- und Streaming-Eigenschaften dominieren, erfordern hochfrequente Plattformdienste wie Suche, E-Commerce und Content-Empfehlungen strikte Echtzeitgrenzen bei maximaler Auslastung der Hardware.
Die Arbeit zeigt auf, dass Small Language Models im Bereich von 0,5 bis 1 Milliarde Parametern durch statische AOT-Kompilierung und deterministische Graphenausführung wirtschaftlich tragfähig in Kernsysteme integriert werden können. Dies liefert einen praxiserprobten Leitfaden für Plattformbetreiber, die generative Modelle im großen Stil in bestehende Empfehlungsarchitekturen einbetten möchten.
Häufig gestellte Fragen
Warum reicht eine Standard-Engine wie SGLang für diese Anwendungsfälle nicht aus?
Standard-Engines sind auf flexible, zustandsbehaftete Mehrbenutzer-Konversationen mit variabler Ausgabelänge ausgelegt. Sie verursachen durch Python-Scheduling und dynamische Verwaltung Overhead, der bei extrem niedrigen Latenzanforderungen von unter 20 Millisekunden untragbar wird. Meituan nutzt stattdessen deterministische DAGs und eine reine C++-Laufzeitumgebung.
Was versteht man unter einer beschränkten Generierungslast (Bounded Generation Workload)?
Darunter versteht man Anfragen, deren maximaler Rechenaufwand, Kontrollfluss und Dekodierschritte bereits vor der Ausführung exakt feststehen. Dazu gehören Klassifikationsaufgaben ohne Dekodierung (Prefill-Only) oder strukturierte Generierungen mit festem Beam-Search-Limit.
Weshalb verzichtet das Framework auf einen anfrageübergreifenden Prefix-Cache?
In Such- und Empfehlungsszenarien weisen Anfragen verschiedener Nutzer nur eine sehr geringe Überschneidung bei Präfixen auf. Der Verwaltungs- und Synchronisationsaufwand für einen globalen PrefixCache übersteigt den Nutzen, weshalb Meituan den Cache ausschließlich anforderungsintern für gemeinsame Präfixe nutzt.