Zurück zur Übersicht
Technische AnleitungOpenAIChatGPTAzure Cosmos DB

OpenAI skaliert Onlinespeicher für über 1 Milliarde ChatGPT-Nutzer: Teil 2 der Infrastruktur-Optimierung

OpenAI hat Details zur Skalierung von Habitat veröffentlicht, um über eine Milliarde ChatGPT-Nutzer zu unterstützen. Durch den Einsatz von zuverlässigem Multi-Tenancy, globalem Caching und Azure Cosmos DB konnte das Unternehmen eine zwölffach schnellere Lesegeschwindigkeit für ChatGPT erreichen. Dieser zweite Teil der technischen Einblicke zeigt, wie die Infrastruktur optimiert wurde, um den enormen globalen Anforderungen gerecht zu werden und die Performance für Nutzer weltweit signifikant zu verbessern.

OpenAI Blog

Die wichtigsten Punkte

  • Skalierung von Habitat zur Unterstützung von über 1 Milliarde ChatGPT-Nutzer
  • Einsatz von zuverlässigem Multi-Tenancy und globalem Caching
  • Nutzung von Azure Cosmos DB zur Infrastruktur-Optimierung
  • Erzielung einer 12-mal schnelleren Lesegeschwindigkeit für ChatGPT

Technische Optimierung von Habitat

OpenAI hat Einblicke in die Skalierung seines Onlinespeichers gegeben, um mehr als eine Milliarde ChatGPT-Nutzer zuverlässig bedienen zu können. Im Mittelpunkt dieser technischen Entwicklung steht das System Habitat. Durch gezielte architektonische Maßnahmen wurde die Infrastruktur so angepasst, dass sie den massiven Datenanforderungen standhalten kann.

Ein zentraler Baustein dieser Skalierung ist die Implementierung von zuverlässigem Multi-Tenancy. Dies ermöglicht eine effiziente Ressourcennutzung und Mandantentrennung. Ergänzt wird dies durch den Einsatz von globalem Caching, welches Zugriffe beschleunigt und die Latenz für Anwender weltweit reduziert.

Einsatz von Azure Cosmos DB

Ein entscheidender Faktor für den Erfolg dieser Optimierungen ist die Integration von Azure Cosmos DB. Die Datenbanktechnologie unterstützt das System dabei, globale Anforderungen zu bewältigen und gleichzeitig eine hohe Zuverlässigkeit zu gewährleisten. Durch die Kombination dieser Technologien konnte OpenAI messbare Leistungssteigerungen erzielen.

Bedeutung für die KI-Branche

Die erfolgreiche Skalierung von Onlinespeichern für über eine Milliarde Nutzer verdeutlicht die enormen infrastrukturellen Herausforderungen im Bereich generativer KI-Anwendungen. Die von OpenAI eingesetzten Methoden wie zuverlässiges Multi-Tenancy, globales Caching und die Nutzung von Azure Cosmos DB zeigen branchenweit relevante Lösungsansätze auf, um extrem hohe Nutzerzahlen mit schneller Leseleistung und stabiler Performance zu verbinden.

Wie viele ChatGPT-Nutzer werden durch die Skalierung unterstützt?

Die Infrastruktur ist darauf ausgelegt, über eine Milliarde ChatGPT-Nutzer zu bedienen.

Welche Technologien wurden zur Leistungssteigerung eingesetzt?

Es wurden zuverlässiges Multi-Tenancy, globales Caching und Azure Cosmos DB verwendet, um Habitat zu skalieren.
Ähnliche Nachrichten

Sichere Sandbox für KI-Agenten wählen: LangChain nennt vier Themen für die Auswahl
Technische Anleitung

Sichere Sandbox für KI-Agenten wählen: LangChain nennt vier Themen für die Auswahl

LangChain stellt die Frage, wie sich eine sichere Sandbox für KI-Agenten auswählen lässt. Die Kurzmeldung nennt vier Themen, zu denen der Beitrag Orientierung geben soll: die Isolierung des Dateisystems, den Netzwerkzugriff, die Begrenzung von Ressourcen und MicroVMs. Damit gibt die Meldung einen Überblick über die Themen des Leitfadens, ohne dessen Empfehlungen im Einzelnen wiederzugeben. Aus der Kurzbeschreibung geht weder hervor, wie LangChain die vier Themen gewichtet, noch welche Einstellungen oder Lösungen der Beitrag empfiehlt. Auch die Rolle von MicroVMs bei der Auswahl wird nicht näher erläutert. Die Meldung lässt sich daher als Einstieg in die Auswahlfrage lesen, nicht als konkrete Entscheidungshilfe für eine bestimmte Sandbox.

Implementierung proaktiver, dauerhafter Agents mit dem Schedules SDK in Managed Deep Agents von LangChain
Technische Anleitung

Implementierung proaktiver, dauerhafter Agents mit dem Schedules SDK in Managed Deep Agents von LangChain

LangChain hat Informationen zur Entwicklung von proaktiven, 'Always-On'-Agents veröffentlicht, die das Schedules SDK innerhalb der Managed Deep Agents nutzen. Während viele dieser Agents bisher auf einfachen Cron-Jobs basierten, bietet das neue SDK erweiterte Möglichkeiten. Der Artikel beleuchtet, wie geplante Ausführungen („Scheduled Runs“) Funktionen wie ein verbessertes Gedächtnis und intelligente Triage-Prozesse freischalten können. Entwickler erfahren, wie sie diese Funktionen in ihre Managed Deep Agents integrieren, um deren Leistungsfähigkeit und Automatisierungsgrad zu steigern. Diese Entwicklung markiert einen Schritt weg von simplen zeitgesteuerten Skripten hin zu robusteren, proaktiven KI-Systemen, die eigenständig agieren und auf komplexe Anforderungen in Echtzeit reagieren können.

Klassifikator-Wahrscheinlichkeiten in scikit-learn kalibrieren: Fehlkalibrierung erkennen und mit zwei Verfahren korrigieren
Technische Anleitung

Klassifikator-Wahrscheinlichkeiten in scikit-learn kalibrieren: Fehlkalibrierung erkennen und mit zwei Verfahren korrigieren

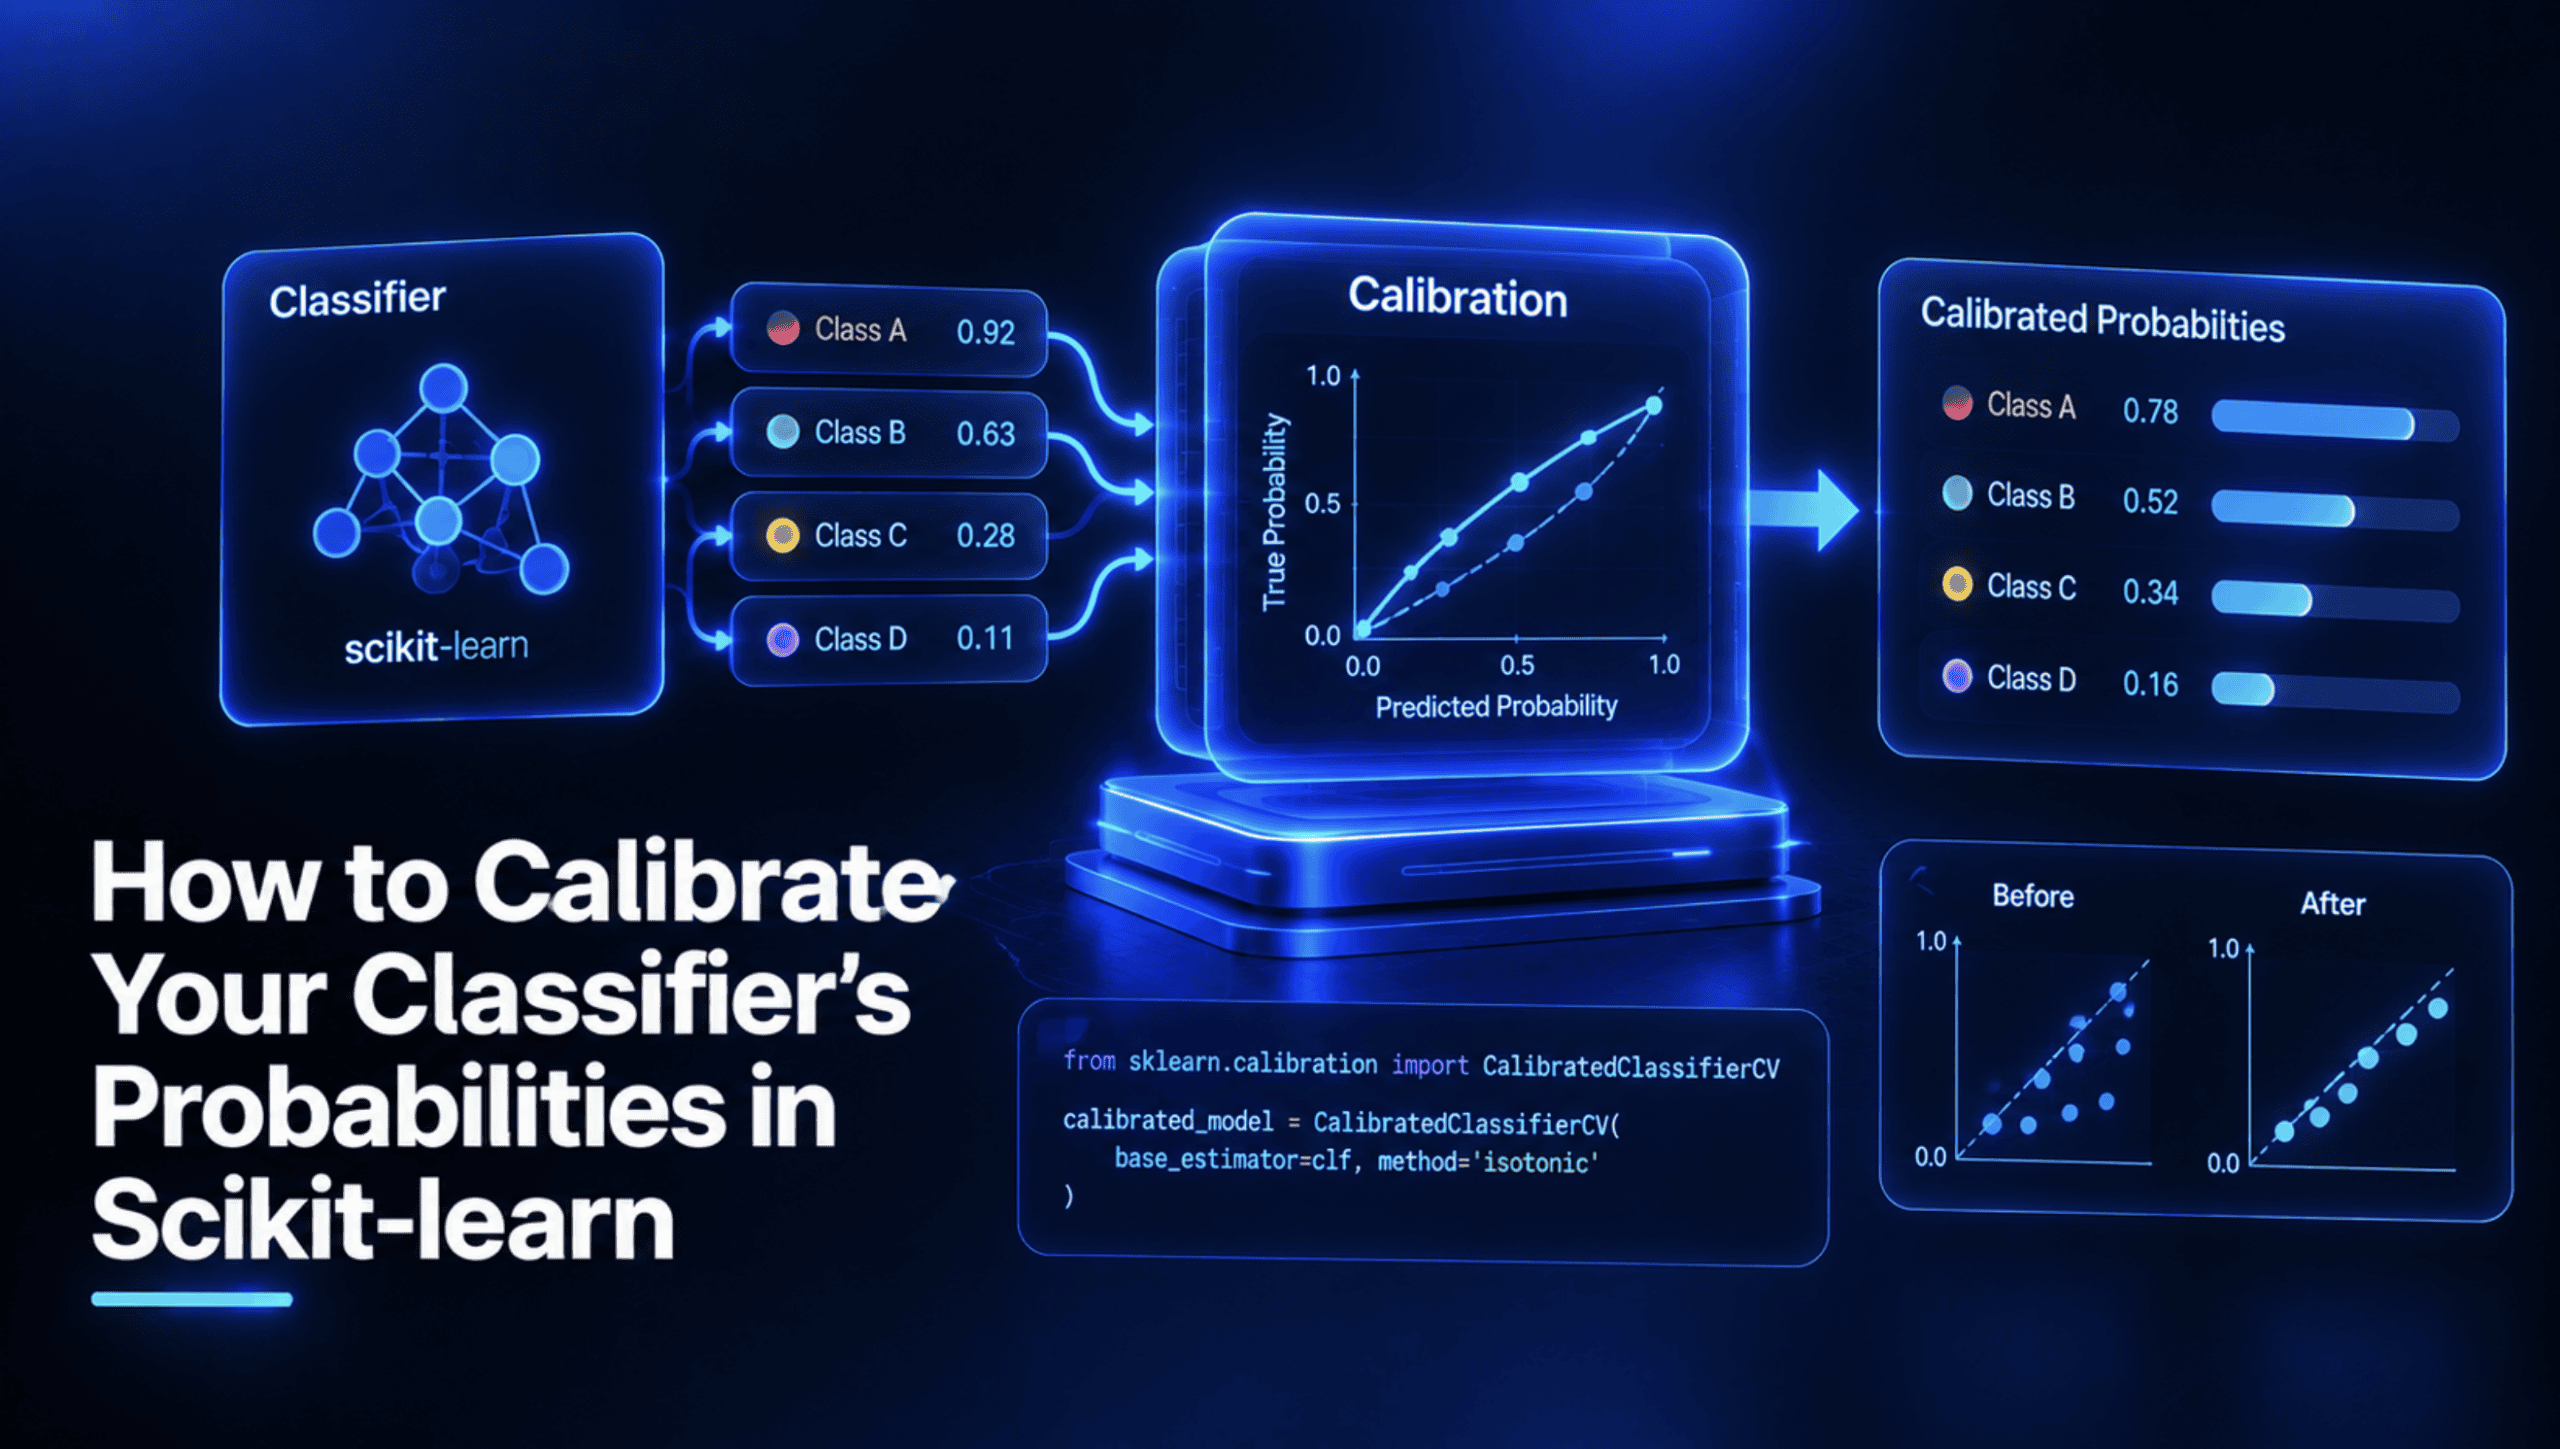
In einem Tutorial für KDnuggets zeigt Shittu Olumide, wie sich die Wahrscheinlichkeiten von Klassifikatoren in scikit-learn überprüfen und kalibrieren lassen. Die Anleitung beginnt mit dem Training zweier Klassifikatoren auf einem realen Datensatz. Anschließend macht sie deren Fehlkalibrierung mit einem Zuverlässigkeitsdiagramm und dem Brier-Score sichtbar. Damit verbindet das Tutorial eine grafische Darstellung mit einer Kennzahl, bevor es zur Korrektur übergeht. Dafür kommen zwei Verfahren zum Einsatz: die Platt-Skalierung und die isotone Regression. Der Ablauf reicht somit vom Modelltraining über die Prüfung der ausgegebenen Wahrscheinlichkeiten bis zu ihrer Kalibrierung. Im Mittelpunkt steht die Frage, wie sich eine Fehlkalibrierung erkennen lässt und welche Verfahren die Anleitung zu ihrer Korrektur einsetzt.