
Meituan veröffentlicht LongCat-2.5: Neues natives multimodales KI-Modell für komplexe Agentenaufgaben mit 1,6 Billionen Parametern
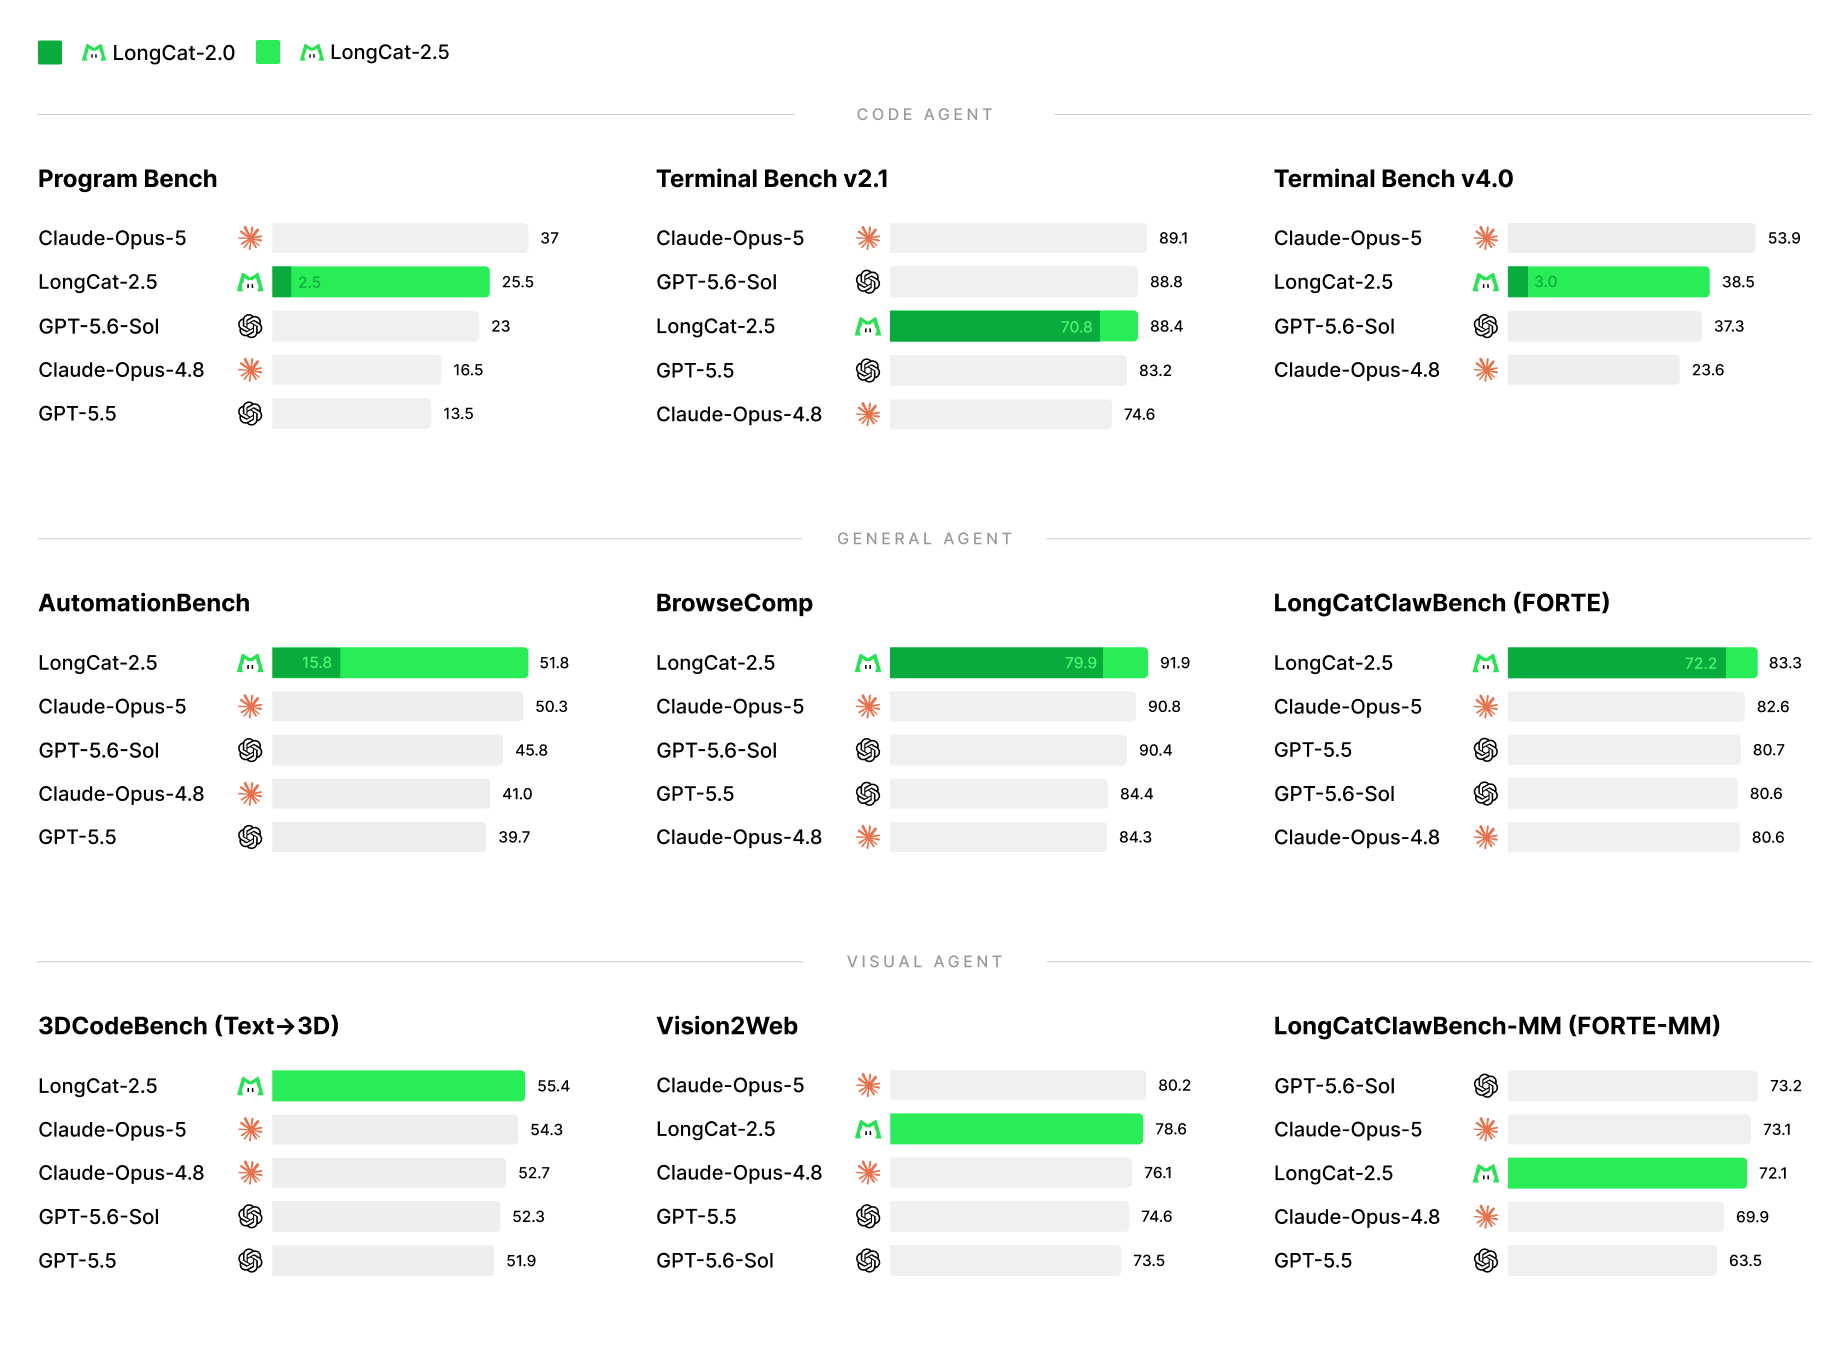
Das Technikteam von Meituan hat offiziell das neue Modell LongCat-2.5 vorgestellt. Hierbei handelt es sich um ein natives multimodales KI-Modell, das gezielt für langreichweitige Agentenaufgaben konzipiert wurde. Die Modellarchitektur weist eine Gesamtzahl von 1,6 Billionen Parametern auf, wobei pro verarbeitetem Token rund 48 Milliarden Parameter aktiviert werden. Als Weiterentwicklung des Vorgängermodells LongCat-2.0 bringt das System substanzielle funktionale Verbesserungen mit sich: Insbesondere das native visuelle Verständnis sowie die Programmierfähigkeiten für autonome Agenten wurden maßgeblich verstärkt. Die Veröffentlichung markiert einen weiteren Schritt bei der Bereitstellung hochskalierter Architekturen für anspruchsvolle Problemlösungen, bei denen multimodale Wahrnehmung und softwarebasierte Agentensteuerung Hand in Hand gehen. Damit adressiert Meituan komplexe Workflows, die über einzelne Abfragen weit hinausreichen.
Die wichtigsten Punkte
- Offizielle Vorstellung: Das Technikteam von Meituan hat das neue Modell LongCat-2.5 angekündigt.
- Ausrichtung auf Agenten: Das System ist als natives multimodales Modell spezifisch für langreichweitige Aufgaben von KI-Agenten konzipiert.
- Enorme Modellskalierung: Das Modell verfügt über ein Gesamtvolumen von 1,6 Billionen Parametern.
- Selektive Aktivierung: Pro verarbeitetem Token werden ca. 48 Milliarden Parameter aktiviert.
- Gezielte Weiterentwicklung: Gegenüber der Vorgängerversion LongCat-2.0 wurden vor allem das native visuelle Verständnis und die Fähigkeiten im Bereich der Agenten-Programmierung ausgebaut.
Analyse
Architekturdimensionen und selektive Parameteraktivierung
Mit der Veröffentlichung von LongCat-2.5 stellt Meituan eine Modellarchitektur vor, deren Gesamtkapazität bei 1,6 Billionen Parametern liegt. Bemerkenswert ist dabei das Verhältnis zwischen dem Gesamtparameterumfang und der tatsächlichen Rechenlast im laufenden Inferenzprozess: Pro einzelnem Token werden etwa 48 Milliarden Parameter aktiviert.
Dieser architektonische Ansatz ermöglicht es dem Modell, ein außergewöhnlich breites Wissens- und Repräsentationsspektrum innerhalb der Gesamtheit von 1,6 Billionen Parametern vorzuhalten, während der Aufwand pro Verarbeitungsschritt auf den Bruchteil von rund 48 Milliarden Parametern begrenzt bleibt. Das Technikteam setzt damit auf eine effiziente Ressourcennutzung bei gleichzeitig massiver Modellgröße, um auch anspruchsvolle Inferenzanforderungen operabel zu halten.
Weiterentwicklung von LongCat-2.0: Fokus auf visuelles Verständnis und Code
LongCat-2.5 baut unmittelbar auf dem Vorgänger LongCat-2.0 auf und führt dessen technologische Ausrichtung gezielt fort. Aus den Angaben von Meituan geht hervor, dass zwei Kernkompetenzen im Zentrum dieser Weiterentwicklung stehen:
- Natives visuelles Verständnis: Die multimodale Verarbeitung ist nicht als nachträglich aufgesetzte Komponente implementiert, sondern nativ im Modell verankert. Dies zielt darauf ab, visuelle Informationen direkt und kohärent im Kontext weiterer Datenströme zu interpretieren.
- Agenten-Programmierung: Die Fähigkeiten zur Erstellung, Analyse und Ausführung von Programmcode durch Software-Agenten wurden im Vergleich zur Version 2.0 substanziell verstärkt. Programmierfähigkeiten gelten als fundamentale Voraussetzung, um Schnittstellen zu bedienen, logische Abläufe zu strukturieren und externe Tools anzusteuern.
Die Kombination aus nativer Bildverarbeitung und Programmierkompetenz bildet das Rückgrat für die Bewältigung vielschichtiger Agentenprozesse.
Spezialisierung auf langreichweitige Agentenaufgaben
Ein zentrales Definitionsmerkmal von LongCat-2.5 ist die explizite Ausrichtung auf langreichweitige Agentenaufgaben. Während einfache multimodale Systeme häufig auf isolierte Aufgaben wie Bildbeschreibungen oder kurze Frage-Antwort-Interaktionen beschränkt sind, verlangen langreichweitige Agentenprozesse ein anhaltendes Verfolgen komplexer Handlungsstränge.
Für derartige Einsätze müssen Modelle in der Lage sein, visuelle Eingaben über viele Schritte hinweg präzise einzuordnen und mit programmierbaren Aktionen zu verknüpfen. Das Modell adressiert somit Nutzungsszenarien, in denen Agenten selbstständig Teilziele definieren, Zwischenergebnisse visuell prüfen und Code-basierte Schritte ausführen müssen, um übergeordnete Zielvorgaben zu erreichen.
Bedeutung für die KI-Branche
Die Ankündigung von LongCat-2.5 unterstreicht den branchenweiten Trend weg von rein textbasierten Modellen hin zu nativ multimodalen Systemen, die auf autonome Handlungen ausgelegt sind. Dass Meituan hierbei die Kombination aus 1,6 Billionen Gesamtparametern und rund 48 Milliarden aktivierten Parametern pro Token wählt, zeigt, wie stark Skalierung und Selektivität bei modernen Spitzenmodellen ineinandergreifen.
Zudem hebt die explizite Fokussierung auf langreichweitige Agentenaufgaben und Programmierung hervor, dass die Industrie zunehmend den praktischen Nutzen von Modellen als handelnde Einheiten priorisiert. Die Fähigkeit, visuelle Umgebungen nativ zu verstehen und dieses Verständnis in funktionale Programmierschritte umzusetzen, markiert ein wesentliches Kriterium für die Weiterentwicklung autonomer Agentensysteme.
Häufig gestellte Fragen
Was ist LongCat-2.5 und von wem wurde es entwickelt?
LongCat-2.5 ist ein von Meituan beziehungsweise dem Meituan-Technikteam entwickeltes und vorgestelltes natives multimodales KI-Modell, das speziell für langreichweitige Agentenaufgaben entworfen wurde.
Wie groß ist das Modell LongCat-2.5?
Das Modell umfasst ein Gesamtvolumen von 1,6 Billionen Parametern. Während der Verarbeitung wird pro Token ein Teilbereich von rund 48 Milliarden Parametern aktiviert.
Welche Verbesserungen bringt LongCat-2.5 im Vergleich zu LongCat-2.0?
Aufbauend auf der Vorgängerversion LongCat-2.0 wurden bei LongCat-2.5 insbesondere das native visuelle Verständnis sowie die Programmierfähigkeiten für intelligente Agenten weiter gestärkt.


