Zurück zur Übersicht
Claude Code effizient nutzen: So integrieren Sie aktuelle Dokumentationen mit Context7
Technische AnleitungClaude CodeContext7KI-Tools

Claude Code effizient nutzen: So integrieren Sie aktuelle Dokumentationen mit Context7

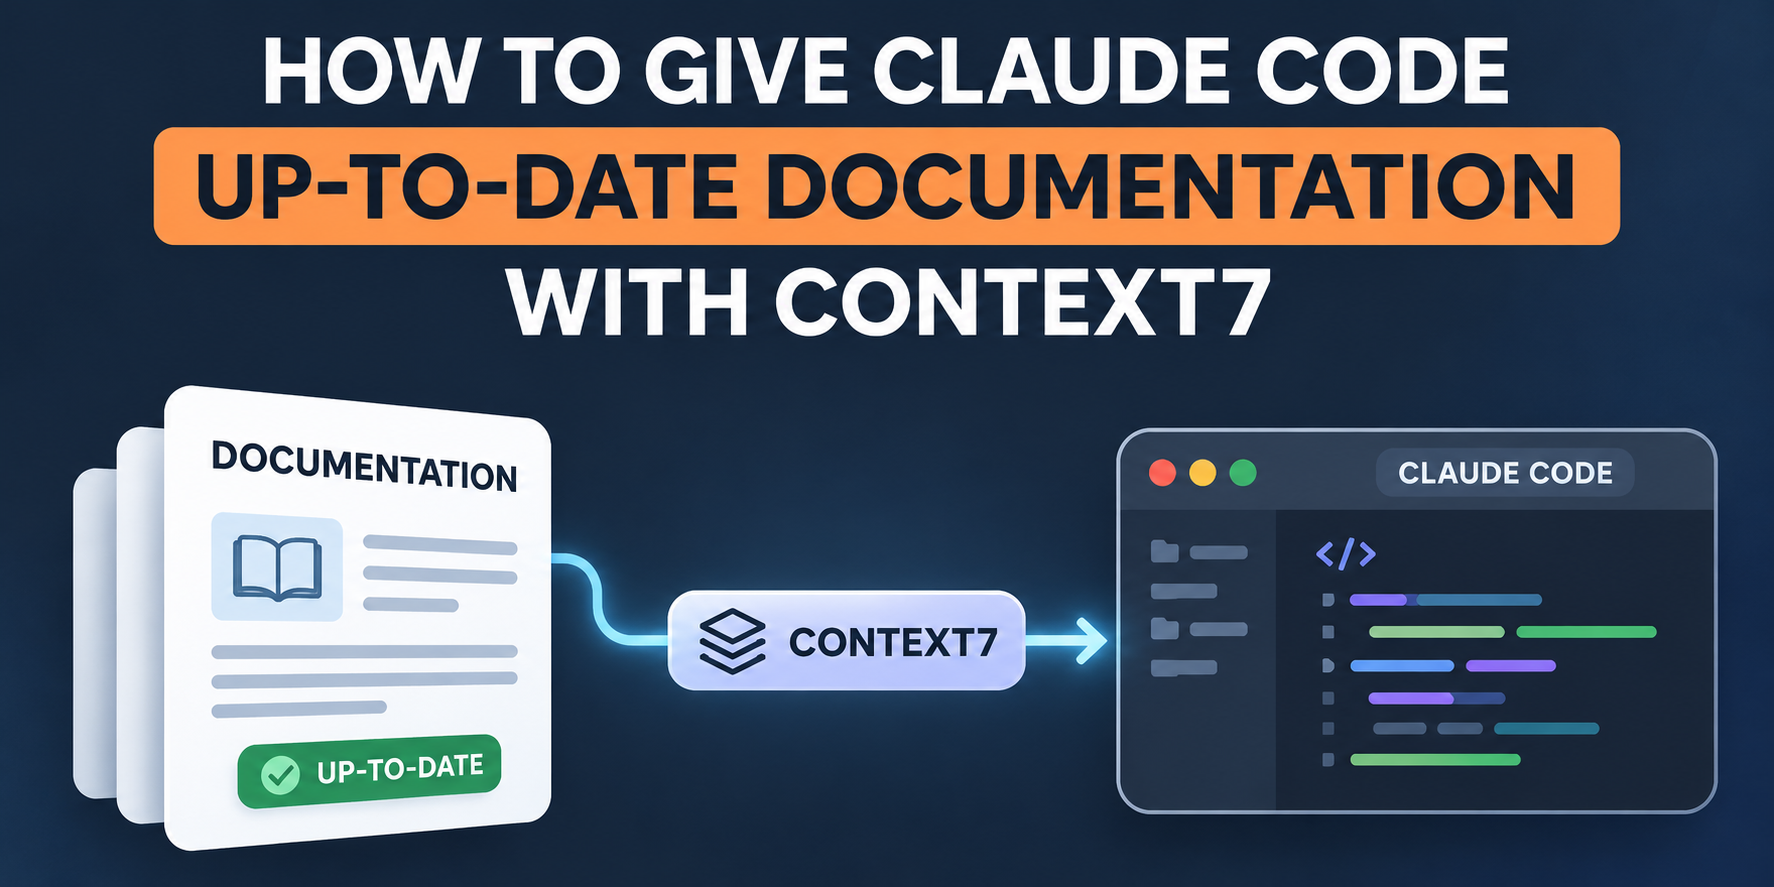
Der Artikel thematisiert die Herausforderung veralteter Code-Dokumentation bei der Arbeit mit Claude Code. Als Lösung wird Context7 vorgestellt, ein Werkzeug, das Claude Code mit aktuellen Dokumentationen versorgt und so die Token-Verschwendung durch unnötiges Debugging reduziert.

KDnuggets

Die wichtigsten Punkte

  • Problemstellung: Die Arbeit mit veralteter Code-Dokumentation führt zu ineffizientem Debugging und unnötigem Token-Verbrauch.
  • Lösung: Context7 dient als Werkzeug, um Claude Code mit aktuellen Dokumentationen auszustatten.
  • Ziel: Effizienzsteigerung und Vermeidung von Fehlern durch präzisere Wissensbasis.

Analyse

Optimierung der Arbeitsweise

Die Entwicklung mit KI-gestützten Tools wie Claude Code steht häufig vor der Herausforderung, dass die zugrundeliegenden Referenzdaten veraltet sein können. Dies zwingt Entwickler dazu, wertvolle Token für das Debugging von Code aufzuwenden, der auf Basis veralteter Informationen erstellt wurde. Eine veraltete Wissensbasis ist einer der Hauptgründe für Ineffizienz in KI-gestützten Workflows.

Einsatz von Context7

Context7 adressiert diese Problematik. Durch die gezielte Einbindung aktueller Dokumentationen kann Claude Code präziser agieren. Dies reduziert den Bedarf an Korrekturschleifen erheblich und stellt sicher, dass der generierte Code den aktuellen Anforderungen entspricht, was die Ressourcenverschwendung minimiert.

Bedeutung für die KI-Branche

Der Einsatz von spezialisierten Kontext-Tools wie Context7 unterstreicht den wachsenden Bedarf an präzisen KI-Workflows in der Softwareentwicklung. In einem Umfeld, in dem die Aktualität der Wissensbasis direkt mit der Qualität des generierten Codes korreliert, werden Lösungen, die die Schnittstelle zwischen externer Dokumentation und KI-Modellen optimieren, zunehmend kritisch für die Produktivität von Entwicklerteams.

Häufig gestellte Fragen

Was ist das Hauptproblem bei der Arbeit mit Claude Code ohne aktuelle Dokumentation?

Ohne Zugriff auf aktuelle Dokumentation generiert Claude Code möglicherweise Code auf Basis veralteter Informationen. Dies führt zu fehlerhaftem Code, der intensives Debugging erfordert und unnötig viele Token verbraucht.

Wie hilft Context7 bei der Verbesserung von Claude Code?

Context7 ermöglicht die Bereitstellung aktueller Dokumentationen. Dadurch erhält Claude Code Zugriff auf relevante und korrekte Informationen, was die Fehlerrate senkt und den Entwicklungsprozess effizienter gestaltet.
Ähnliche Nachrichten

Sichere Sandbox für KI-Agenten wählen: LangChain nennt vier Themen für die Auswahl
Technische Anleitung

Sichere Sandbox für KI-Agenten wählen: LangChain nennt vier Themen für die Auswahl

LangChain stellt die Frage, wie sich eine sichere Sandbox für KI-Agenten auswählen lässt. Die Kurzmeldung nennt vier Themen, zu denen der Beitrag Orientierung geben soll: die Isolierung des Dateisystems, den Netzwerkzugriff, die Begrenzung von Ressourcen und MicroVMs. Damit gibt die Meldung einen Überblick über die Themen des Leitfadens, ohne dessen Empfehlungen im Einzelnen wiederzugeben. Aus der Kurzbeschreibung geht weder hervor, wie LangChain die vier Themen gewichtet, noch welche Einstellungen oder Lösungen der Beitrag empfiehlt. Auch die Rolle von MicroVMs bei der Auswahl wird nicht näher erläutert. Die Meldung lässt sich daher als Einstieg in die Auswahlfrage lesen, nicht als konkrete Entscheidungshilfe für eine bestimmte Sandbox.

Implementierung proaktiver, dauerhafter Agents mit dem Schedules SDK in Managed Deep Agents von LangChain
Technische Anleitung

Implementierung proaktiver, dauerhafter Agents mit dem Schedules SDK in Managed Deep Agents von LangChain

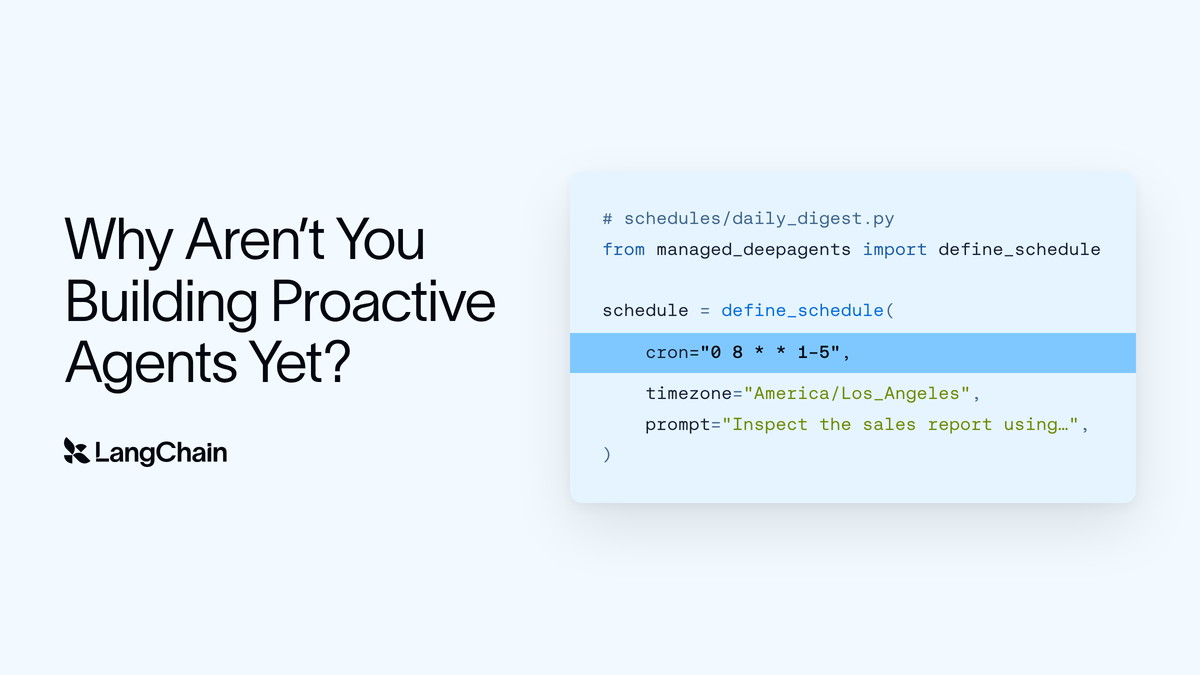
LangChain hat Informationen zur Entwicklung von proaktiven, 'Always-On'-Agents veröffentlicht, die das Schedules SDK innerhalb der Managed Deep Agents nutzen. Während viele dieser Agents bisher auf einfachen Cron-Jobs basierten, bietet das neue SDK erweiterte Möglichkeiten. Der Artikel beleuchtet, wie geplante Ausführungen („Scheduled Runs“) Funktionen wie ein verbessertes Gedächtnis und intelligente Triage-Prozesse freischalten können. Entwickler erfahren, wie sie diese Funktionen in ihre Managed Deep Agents integrieren, um deren Leistungsfähigkeit und Automatisierungsgrad zu steigern. Diese Entwicklung markiert einen Schritt weg von simplen zeitgesteuerten Skripten hin zu robusteren, proaktiven KI-Systemen, die eigenständig agieren und auf komplexe Anforderungen in Echtzeit reagieren können.

Klassifikator-Wahrscheinlichkeiten in scikit-learn kalibrieren: Fehlkalibrierung erkennen und mit zwei Verfahren korrigieren
Technische Anleitung

Klassifikator-Wahrscheinlichkeiten in scikit-learn kalibrieren: Fehlkalibrierung erkennen und mit zwei Verfahren korrigieren

In einem Tutorial für KDnuggets zeigt Shittu Olumide, wie sich die Wahrscheinlichkeiten von Klassifikatoren in scikit-learn überprüfen und kalibrieren lassen. Die Anleitung beginnt mit dem Training zweier Klassifikatoren auf einem realen Datensatz. Anschließend macht sie deren Fehlkalibrierung mit einem Zuverlässigkeitsdiagramm und dem Brier-Score sichtbar. Damit verbindet das Tutorial eine grafische Darstellung mit einer Kennzahl, bevor es zur Korrektur übergeht. Dafür kommen zwei Verfahren zum Einsatz: die Platt-Skalierung und die isotone Regression. Der Ablauf reicht somit vom Modelltraining über die Prüfung der ausgegebenen Wahrscheinlichkeiten bis zu ihrer Kalibrierung. Im Mittelpunkt steht die Frage, wie sich eine Fehlkalibrierung erkennen lässt und welche Verfahren die Anleitung zu ihrer Korrektur einsetzt.