
Transfer Learning für genomische Vorhersagen in unterrepräsentierten Bevölkerungsgruppen: Ein neuer Forschungsansatz von Google Research
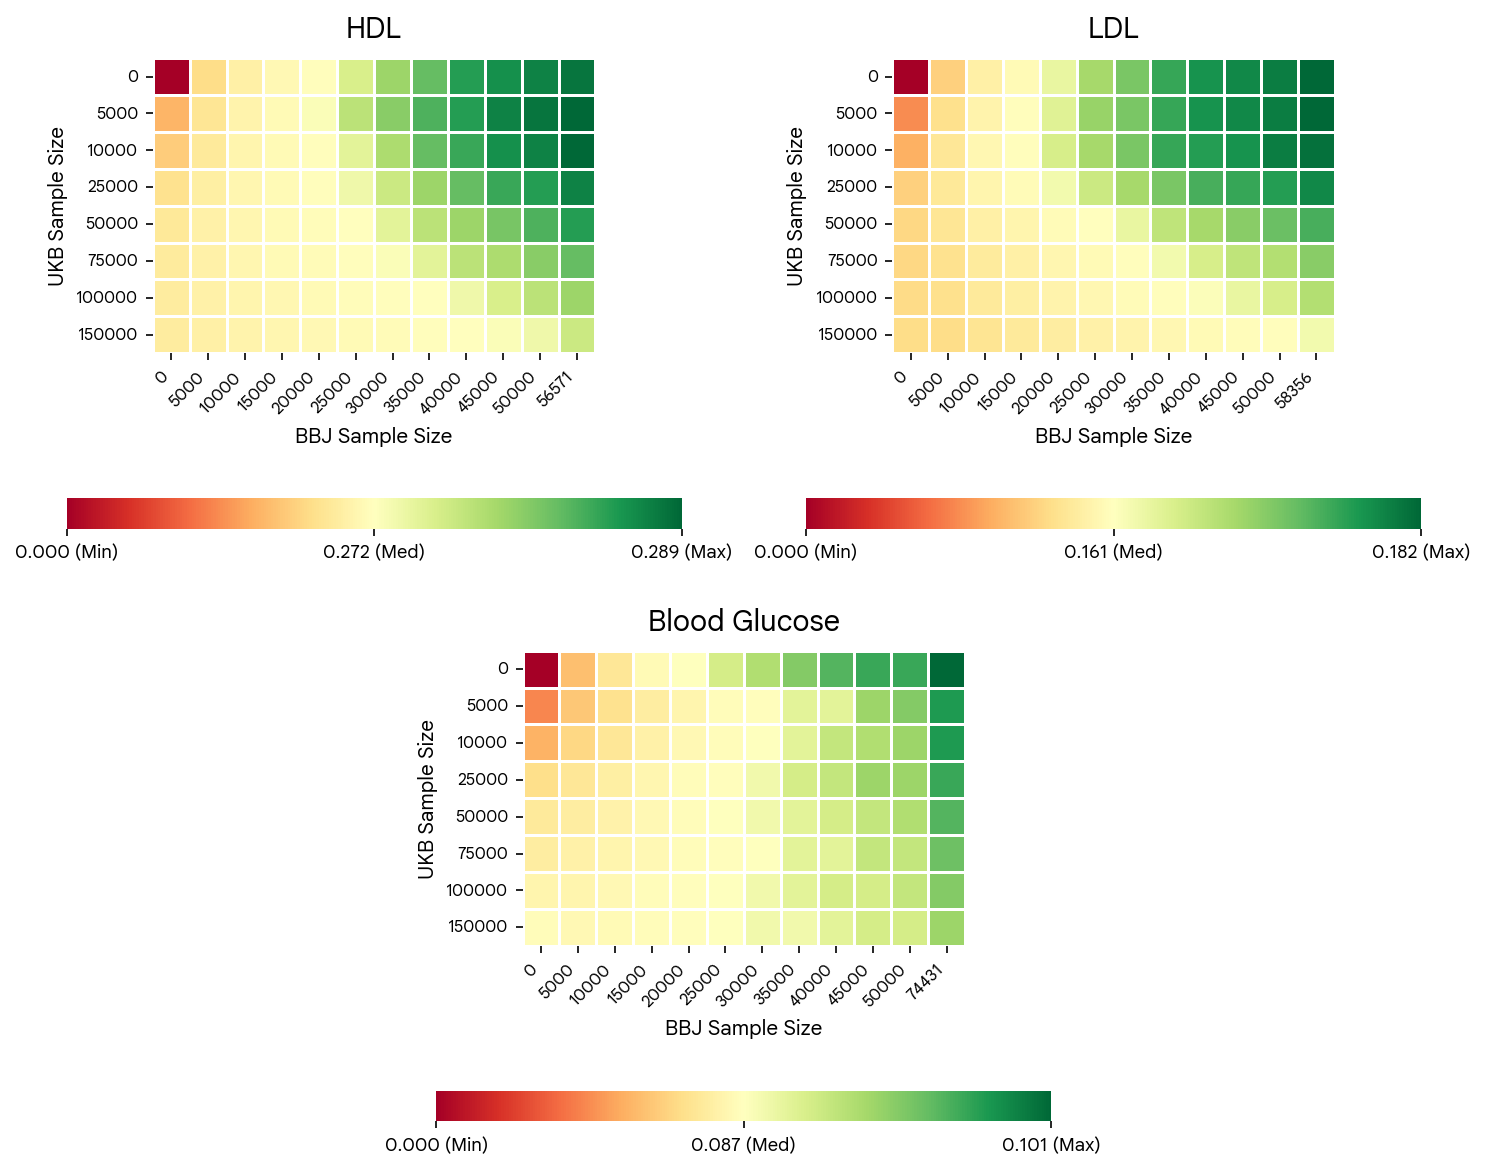
In einer aktuellen Veröffentlichung im Google Research Blog thematisiert das Forschungsteam den Einsatz von Transfer Learning zur Verbesserung genomischer Vorhersagen. Ein zentraler Fokus der Arbeit liegt auf der Einbeziehung unterrepräsentierter Bevölkerungsgruppen in der genetischen Forschung. Da viele bestehende genomische Datensätze eine begrenzte Diversität aufweisen, stellt die Übertragbarkeit von Modellen auf verschiedene ethnische Gruppen eine große Herausforderung dar. Google Research untersucht hierbei, wie Transfer-Learning-Methoden genutzt werden können, um Wissen aus datenreichen Populationen auf Gruppen mit geringerer Datenverfügbarkeit zu übertragen. Dieser Ansatz im Bereich der allgemeinen Wissenschaft (General Science) zielt darauf ab, die Genauigkeit und Fairness genomischer Vorhersagemodelle global zu steigern und bestehende Lücken in der medizinischen Forschung zu schließen.
Die wichtigsten Punkte
- Fokus auf Diversität: Die Forschung adressiert die mangelnde Repräsentation bestimmter Bevölkerungsgruppen in genomischen Studien.
- Methodik des Transfer Learning: Einsatz von KI-Modellen, die Wissen von einer Domäne auf eine andere übertragen, um Datenknappheit zu überwinden.
- Genomische Vorhersage: Verbesserung der Vorhersagegenauigkeit für genetische Merkmale und Krankheitsrisiken.
- Wissenschaftlicher Kontext: Einordnung der Arbeit in den Bereich der allgemeinen Wissenschaft (General Science) durch Google Research.
Analyse
Die Herausforderung der Datenrepräsentation in der Genomik
Die genomische Forschung stützt sich in hohem Maße auf groß angelegte Datensätze, um Zusammenhänge zwischen genetischen Varianten und phänotypischen Merkmalen zu verstehen. Ein kritisches Problem in diesem Feld ist jedoch die einseitige Datenlage: Ein Großteil der verfügbaren genomischen Daten stammt von Individuen europäischer Abstammung. Dies führt dazu, dass Vorhersagemodelle, die auf diesen Daten trainiert wurden, bei unterrepräsentierten Bevölkerungsgruppen oft eine deutlich geringere Genauigkeit aufweisen. Google Research setzt hier an, um die genomische Vorhersage inklusiver zu gestalten.
Die Unterrepräsentation bestimmter Gruppen ist nicht nur ein statistisches Problem, sondern hat direkte Auswirkungen auf die Anwendbarkeit der Präzisionsmedizin. Wenn Modelle genetische Risiken für bestimmte Ethnien nicht korrekt einschätzen können, entstehen Ungleichheiten in der Gesundheitsversorgung. Die aktuelle Forschungsarbeit untersucht daher Wege, wie die KI-gestützte Genomik diese Barrieren überwinden kann.
Transfer Learning als technologischer Lösungsansatz
Transfer Learning ist eine Methode des maschinellen Lernens, bei der ein Modell, das für eine bestimmte Aufgabe entwickelt wurde, als Ausgangspunkt für ein Modell für eine zweite, verwandte Aufgabe wiederverwendet wird. Im Kontext der Google-Forschung bedeutet dies, dass Modelle, die auf großen, bereits existierenden genomischen Datensätzen trainiert wurden, so angepasst werden, dass sie auch für Populationen mit wesentlich kleineren Datenmengen präzise Vorhersagen treffen können.
Durch diesen Wissenstransfer muss das Modell für die unterrepräsentierte Gruppe nicht „bei Null“ anfangen. Stattdessen nutzt es die bereits gelernten biologischen Grundmuster und passt sich lediglich an die spezifischen genetischen Variationen der Zielpopulation an. Dieser Ansatz ist besonders wertvoll, da die Erhebung neuer, umfangreicher genomischer Daten für jede einzelne Bevölkerungsgruppe zeit- und kostenintensiv ist. Transfer Learning bietet somit eine effiziente Möglichkeit, die genomische Vorhersagekraft über verschiedene Gruppen hinweg zu skalieren.
Bedeutung für die KI-Branche
Die Arbeit von Google Research unterstreicht die wachsende Bedeutung von Fairness und Inklusivität in der künstlichen Intelligenz. Für die KI-Branche zeigt dieser Forschungsansatz, dass technologische Innovationen wie Transfer Learning entscheidend sind, um Bias (Voreingenommenheit) in Modellen zu reduzieren. In der Biotechnologie und der Pharmaindustrie könnte die Anwendung solcher Methoden die Entwicklung von Medikamenten und Diagnosetools beschleunigen, die für eine global diverse Bevölkerung wirksam sind. Es verdeutlicht zudem den Trend, KI nicht nur für die Datenverarbeitung, sondern gezielt für den Ausgleich von Datenlücken in der Wissenschaft einzusetzen.
Häufig gestellte Fragen
Was versteht man unter genomischer Vorhersage?
Unter genomischer Vorhersage versteht man den Einsatz statistischer oder maschineller Lernmodelle, um die Ausprägung bestimmter Merkmale oder das Risiko für Krankheiten basierend auf der genetischen Ausstattung eines Individuums vorherzusagen.
Warum ist Transfer Learning in der Genetik so wichtig?
Da für viele Bevölkerungsgruppen weltweit nur begrenzte genomische Daten vorliegen, erlaubt Transfer Learning es der Forschung, Erkenntnisse aus datenreichen Gruppen zu nutzen, um die Vorhersagemodelle für datenarme Gruppen zu verbessern, ohne dass massiv neue Daten erhoben werden müssen.
Welche Rolle spielt Google Research in diesem Bereich?
Google Research nutzt seine Expertise im Bereich des maschinellen Lernens, um komplexe wissenschaftliche Probleme in der Biologie und Medizin zu lösen. Mit der Untersuchung von Transfer Learning für unterrepräsentierte Gruppen trägt das Unternehmen dazu bei, die genomische Forschung gerechter und präziser zu gestalten.
