Meituan-Technikteam stellt Whitepaper zur Agent-Evaluierung vor: Systematischer Leitfaden für die Bewertung intelligenter KI-Agenten
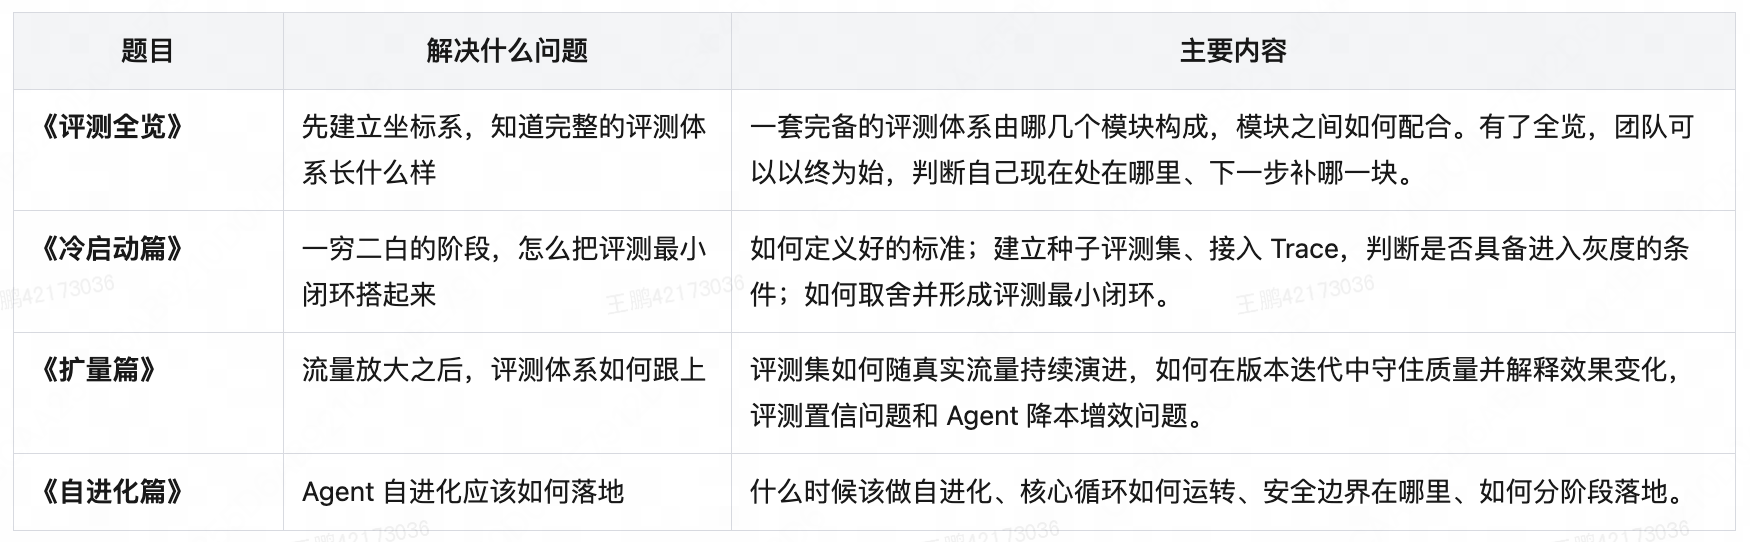
Das Meituan-Technikteam hat den Auftakt zu seiner neuen Blogserie mit dem Titel „Agent-Evaluierungs-Whitepaper“ bekannt gegeben. Die Veröffentlichungsreihe ist darauf ausgelegt, einen systematischen Praxisleitfaden für die fundierte Bewertung und Umsetzung von KI-Agenten bereitzustellen. Der nun vorgestellte erste Beitrag trägt den Titel „Evaluierungsüberblick“ und bildet das Fundament für die insgesamt vierteilige Publikationsreihe. Das Gesamtwerk gliedert sich laut den Autoren in vier thematische Schwerpunkte: den nun vorliegenden Überblick, einen Leitfaden zum Kaltstart, einen Beitrag zur Skalierung und Kapazitätserweiterung sowie einen abschließenden Teil zur Selbstevolution von Agenten. Damit adressiert das technische Team von Meituan die wesentlichen Entwicklungsphasen von Agentensystemen. Die Serie zielt darauf ab, Entwicklern und Fachleuten eine strukturierte Orientierung für die praktische Implementierung von Evaluierungsverfahren an die Hand zu geben.
Die wichtigsten Punkte
- Start einer neuen Fachpublikation: Das Meituan-Technikteam hat die offizielle Veröffentlichung seiner Blogserie „Agent-Evaluierungs-Whitepaper“ eingeleitet.
- Vierteilige Gesamtstruktur: Das Vorhaben ist als vierteilige Reihe konzipiert, bestehend aus den Abschnitten „Evaluierungsüberblick“, „Kaltstart“, „Skalierung“ und „Selbstevolution“.
- Systematischer Praxisleitfaden: Im Mittelpunkt der Reihe steht die methodische und anwendungsbezogene Anleitung zur konkreten Implementierung und Umsetzung von Evaluierungsverfahren.
- Fundament durch Teil 1: Der aktuell veröffentlichte erste Beitrag widmet sich der Gesamtschau („Evaluierungsüberblick“) und legt die Basis für die nachfolgenden Vertiefungen.
Analyse
Struktur und Konzeption der Whitepaper-Reihe
Mit der Veröffentlichung des ersten Beitrags unter dem Titel „Agent-Evaluierungs-Whitepaper Serie 01: Evaluierungsüberblick“ reagiert das Meituan-Technikteam auf die wachsende Notwendigkeit, Bewertungsverfahren für intelligente Agentensysteme strukturiert aufzuarbeiten. Das Vorhaben zeichnet sich durch einen systematischen Aufbau aus, der darauf abzielt, die Implementierung und Verankerung von Evaluierungsansätzen in der Praxis schrittweise zu vermitteln.
Anstatt isolierte Einzelfragen zu behandeln, ist das Gesamtwerk als vierteilige Blogserie angelegt. Diese Unterteilung ermöglicht es, den Lebenszyklus sowie die unterschiedlichen Reifegrade eines Agentensystems in separate, logisch aufeinander aufbauende Phasen zu gliedern. Als Fundament dient der nun erschienene erste Beitrag, der als Gesamtschau fungiert und den thematischen Rahmen für die nachfolgenden Teile absteckt.
Die vier Phasen der Agent-Evaluierung
Der von Meituan vorgestellte Aufbau verdeutlicht einen methodischen Pfad, der die typischen Herausforderungen bei der Entwicklung und dem Betrieb von Agenten nachzeichnet. Die vier Module gliedern sich wie folgt:
- Evaluierungsüberblick (评测全览): Dieser einleitende Teil verschafft der Fachöffentlichkeit eine umfassende Gesamtschau über das Thema der Agenten-Evaluation und dient als Ausgangspunkt für die gesamte Reihe.
- Kaltstart (冷启动篇): Der zweite Teil befasst sich mit der initialen Phase, in der noch wenige Daten oder Erfahrungswerte vorliegen, und thematisiert die ersten Schritte zur Etablierung valider Bewertungsmaßstäbe.
- Skalierung (扩量篇): Im dritten Schritt steht die quantitative Ausweitung und Skalierung im Mittelpunkt, wenn Agenten größere Aufgabenbereiche oder höhere Lasten bewältigen müssen.
- Selbstevolution (自进化篇): Das abschließende Modul adressiert fortgeschrittene Szenarien, in denen Systeme sich eigenständig weiterentwickeln und adaptive Evaluierungsmechanismen erfordern.
Fokus auf die praktische Umsetzung
Ein zentrales Charakteristikum der Initiative des Meituan-Technikteams ist der explizite Anspruch, einen praktischen Leitfaden für die reale Umsetzung bereitzustellen. Das Whitepaper beschränkt sich nicht auf rein theoretische Erörterungen, sondern konzentriert sich darauf, wie Bewertungsverfahren in realen Entwicklungsumgebungen verankert werden können. Dieser anwendungsorientierte Ansatz spiegelt sich in der konsequenten Ausrichtung aller vier Teile wider.
Bedeutung für die KI-Branche
Die Veröffentlichung einer systematischen Leitfadenserie zur Evaluierung von KI-Agenten unterstreicht die wachsende Relevanz von Qualitäts- und Bewertungsprozessen in der KI-Entwicklung. Während Sprachmodelle und agentenbasierte Architekturen rasch weiterentwickelt werden, stellt die verlässliche, praxistaugliche Bewertung dieser Systeme eine der zentralen Herausforderungen dar.
Indem das Meituan-Technikteam die Evaluierung in vier klare Phasen – von der Orientierung über den Kaltstart und die Skalierung bis hin zur Selbstevolution – unterteilt, wird ein strukturierter Bezugsrahmen für Ingenieure und Forschende geschaffen. Die Initiative zeigt, dass Evaluierungsprozesse integraler Bestandteil des gesamten Lebenszyklus moderner Agentenarchitekturen sein müssen, um deren Zuverlässigkeit und Leistungsfähigkeit nachhaltig sicherzustellen.
Häufig gestellte Fragen
Aus welchen Teilen besteht das Agent-Evaluierungs-Whitepaper von Meituan?
Die Reihe umfasst insgesamt vier aufeinander aufbauende Beiträge: den „Evaluierungsüberblick“, das Kapitel zum „Kaltstart“, den Beitrag zur „Skalierung“ sowie den abschließenden Teil zur „Selbstevolution“.
Was ist das Hauptziel dieser Whitepaper-Serie?
Das Ziel besteht darin, Fachleuten einen systematischen und praxisorientierten Leitfaden zur Verfügung zu stellen, der die konkrete Umsetzung und Durchführung von Evaluierungsverfahren für KI-Agenten umfassend erklärt.
Welcher Beitrag wurde aktuell veröffentlicht?
Aktuell wurde der erste Teil der Serie veröffentlicht, der unter dem Titel „Evaluierungsüberblick“ die thematische Grundlage für die gesamte vierteilige Veröffentlichungsreihe bildet.