Zurück zur Übersicht
Integration von LLM-Übersetzungen in Scikit-Learn-Pipelines mit Scikit-LLM für mehrsprachige Textklassifikation
Technische AnleitungScikit-LearnScikit-LLMNLP

Integration von LLM-Übersetzungen in Scikit-Learn-Pipelines mit Scikit-LLM für mehrsprachige Textklassifikation

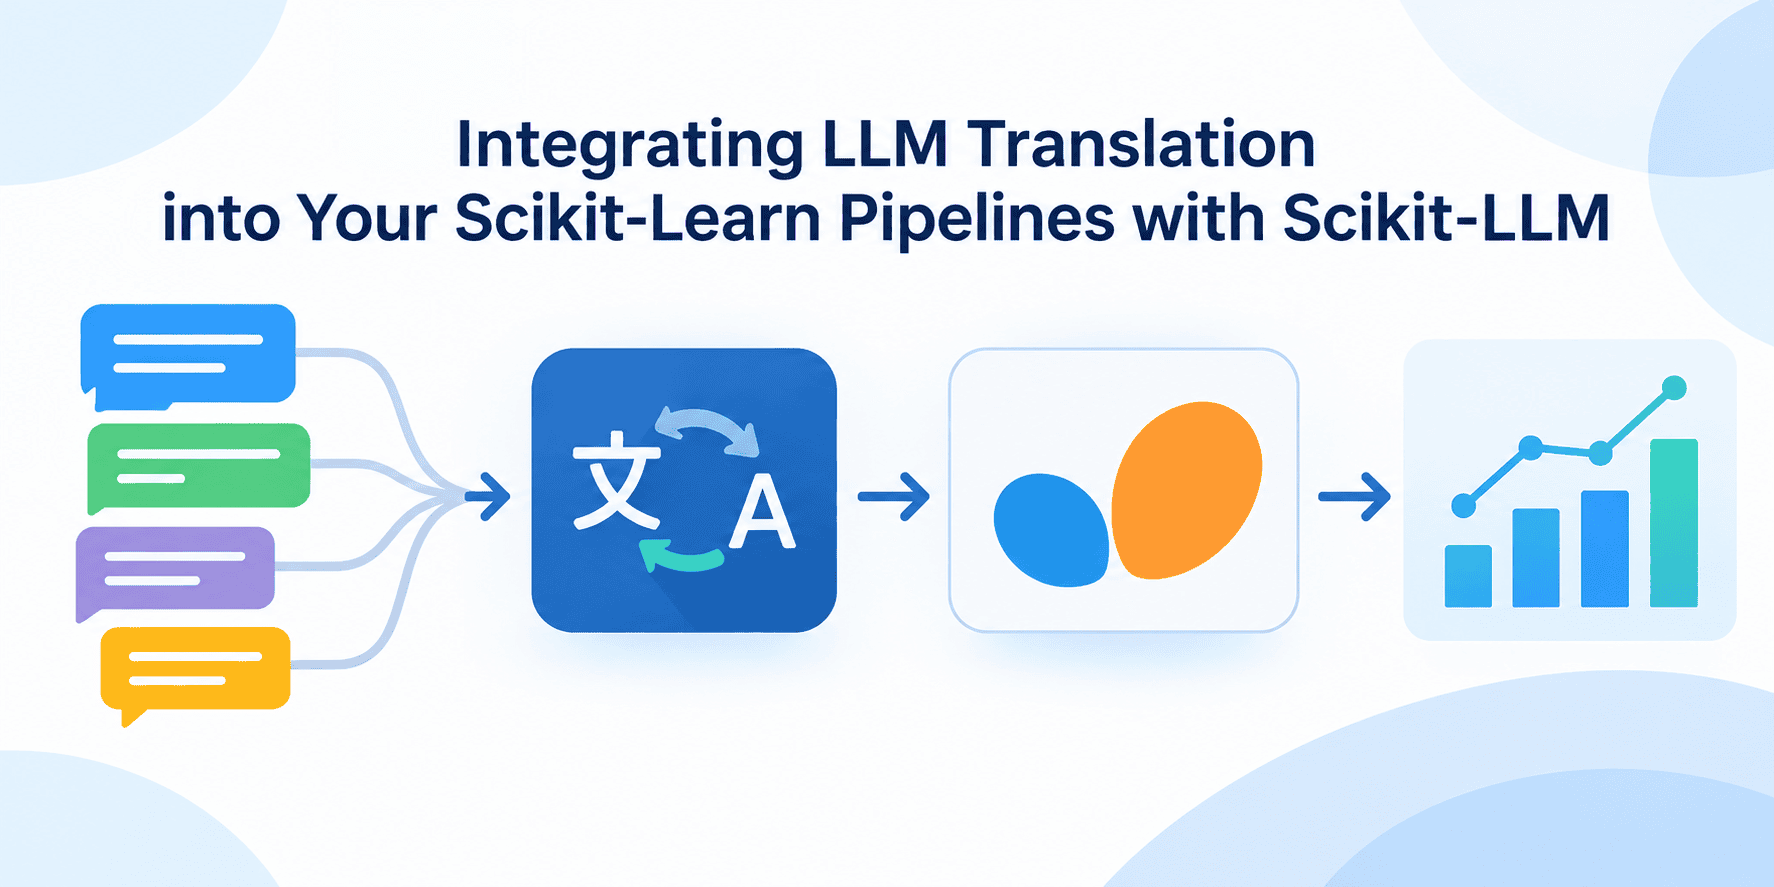
Erfahren Sie in wenigen einfachen Schritten, wie Sie eine zweistufige Scikit-Learn-Pipeline für die mehrsprachige Textklassifikation erstellen. Die Anleitung wird durch zwei vortrainierte Sprachmodelle gesteuert, die von Scikit-LLM für die Übersetzung sowie für die Zero-Shot-Klassifikation gehandhabt werden. Dieser strukturierte Ansatz zeigt, wie moderne Werkzeuge kombiniert werden können, um textbasierte maschinelle Lernprozesse zu optimieren und umzusetzen, basierend auf den von Scikit-LLM bereitgestellten Funktionen.

KDnuggets

Die wichtigsten Punkte

  • Erstellung einer zweistufigen Scikit-Learn-Pipeline für mehrsprachige Textklassifikation.
  • Nutzung von Scikit-LLM zur Handhabung von zwei vortrainierten Sprachmodellen.
  • Durchführung von Aufgaben wie Übersetzung und Zero-Shot-Klassifikation in wenigen Schritten.

Analyse

Kombination von Scikit-Learn und Scikit-LLM

Die Integration von fortschrittlichen Sprachmodellen in traditionelle Workflows des maschinellen Lernens stellt Entwickler oft vor Herausforderungen. Durch den Einsatz von Scikit-LLM wird es möglich, vortrainierte Sprachmodelle nahtlos zu handhaben. Die Originalmeldung beschreibt konkret die Erstellung einer zweistufigen Scikit-Learn-Pipeline, die speziell auf die Anforderungen der mehrsprachigen Textklassifikation ausgerichtet ist.

Übersetzung und Zero-Shot-Klassifikation

Ein zentraler Aspekt dieses Ansatzes ist die Aufteilung oder Nutzung der Modelle für spezifische Aufgaben. Dabei werden zwei vortrainierte Sprachmodelle eingesetzt, die jeweils für die Übersetzung und für die Zero-Shot-Klassifikation verantwortlich sind. Diese strukturierte Methode ermöglicht es, sprachübergreifende Daten effizient innerhalb einer vertrauten Pipeline-Umgebung zu verarbeiten.

Bedeutung für die KI-Branche

Die Verknüpfung von etablierten Bibliotheken für maschinelles Lernen wie Scikit-Learn mit modernen Large Language Models über Frameworks wie Scikit-LLM zeigt einen praktischen Weg auf, wie Entwickler bestehende Systeme erweitern können. Dies erleichtert die Implementierung mehrsprachiger Textklassifikationen, ohne dass dafür gänzlich neue Architekturparadigmen von Grund auf neu entwickelt werden müssen.

Häufig gestellte Fragen

Was ist der Zweck dieser Integration?

Der Zweck ist die Erstellung einer zweistufigen Scikit-Learn-Pipeline für mehrsprachige Textklassifikation unter Verwendung von Scikit-LLM.

Welche Funktionen werden durch die Sprachmodelle abgedeckt?

Die beiden vortrainierten Sprachmodelle werden für die Übersetzung und für die Zero-Shot-Klassifikation eingesetzt.
Ähnliche Nachrichten

Sichere Sandbox für KI-Agenten wählen: LangChain nennt vier Themen für die Auswahl
Technische Anleitung

Sichere Sandbox für KI-Agenten wählen: LangChain nennt vier Themen für die Auswahl

LangChain stellt die Frage, wie sich eine sichere Sandbox für KI-Agenten auswählen lässt. Die Kurzmeldung nennt vier Themen, zu denen der Beitrag Orientierung geben soll: die Isolierung des Dateisystems, den Netzwerkzugriff, die Begrenzung von Ressourcen und MicroVMs. Damit gibt die Meldung einen Überblick über die Themen des Leitfadens, ohne dessen Empfehlungen im Einzelnen wiederzugeben. Aus der Kurzbeschreibung geht weder hervor, wie LangChain die vier Themen gewichtet, noch welche Einstellungen oder Lösungen der Beitrag empfiehlt. Auch die Rolle von MicroVMs bei der Auswahl wird nicht näher erläutert. Die Meldung lässt sich daher als Einstieg in die Auswahlfrage lesen, nicht als konkrete Entscheidungshilfe für eine bestimmte Sandbox.

Implementierung proaktiver, dauerhafter Agents mit dem Schedules SDK in Managed Deep Agents von LangChain
Technische Anleitung

Implementierung proaktiver, dauerhafter Agents mit dem Schedules SDK in Managed Deep Agents von LangChain

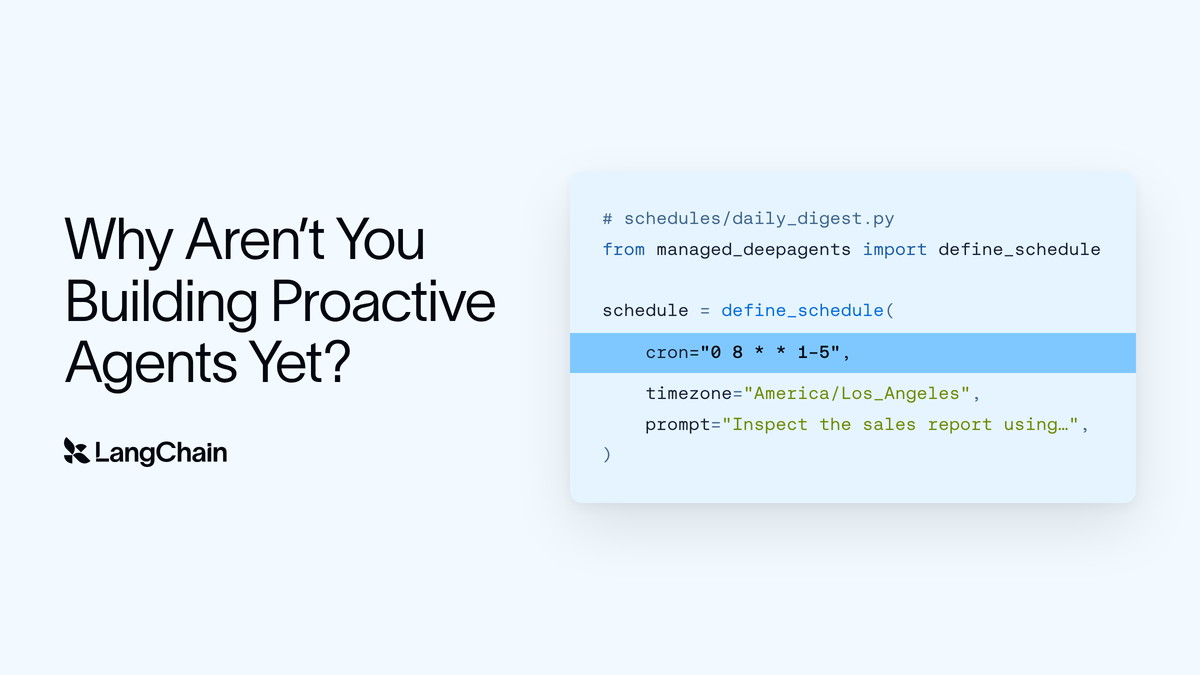
LangChain hat Informationen zur Entwicklung von proaktiven, 'Always-On'-Agents veröffentlicht, die das Schedules SDK innerhalb der Managed Deep Agents nutzen. Während viele dieser Agents bisher auf einfachen Cron-Jobs basierten, bietet das neue SDK erweiterte Möglichkeiten. Der Artikel beleuchtet, wie geplante Ausführungen („Scheduled Runs“) Funktionen wie ein verbessertes Gedächtnis und intelligente Triage-Prozesse freischalten können. Entwickler erfahren, wie sie diese Funktionen in ihre Managed Deep Agents integrieren, um deren Leistungsfähigkeit und Automatisierungsgrad zu steigern. Diese Entwicklung markiert einen Schritt weg von simplen zeitgesteuerten Skripten hin zu robusteren, proaktiven KI-Systemen, die eigenständig agieren und auf komplexe Anforderungen in Echtzeit reagieren können.

Klassifikator-Wahrscheinlichkeiten in scikit-learn kalibrieren: Fehlkalibrierung erkennen und mit zwei Verfahren korrigieren
Technische Anleitung

Klassifikator-Wahrscheinlichkeiten in scikit-learn kalibrieren: Fehlkalibrierung erkennen und mit zwei Verfahren korrigieren

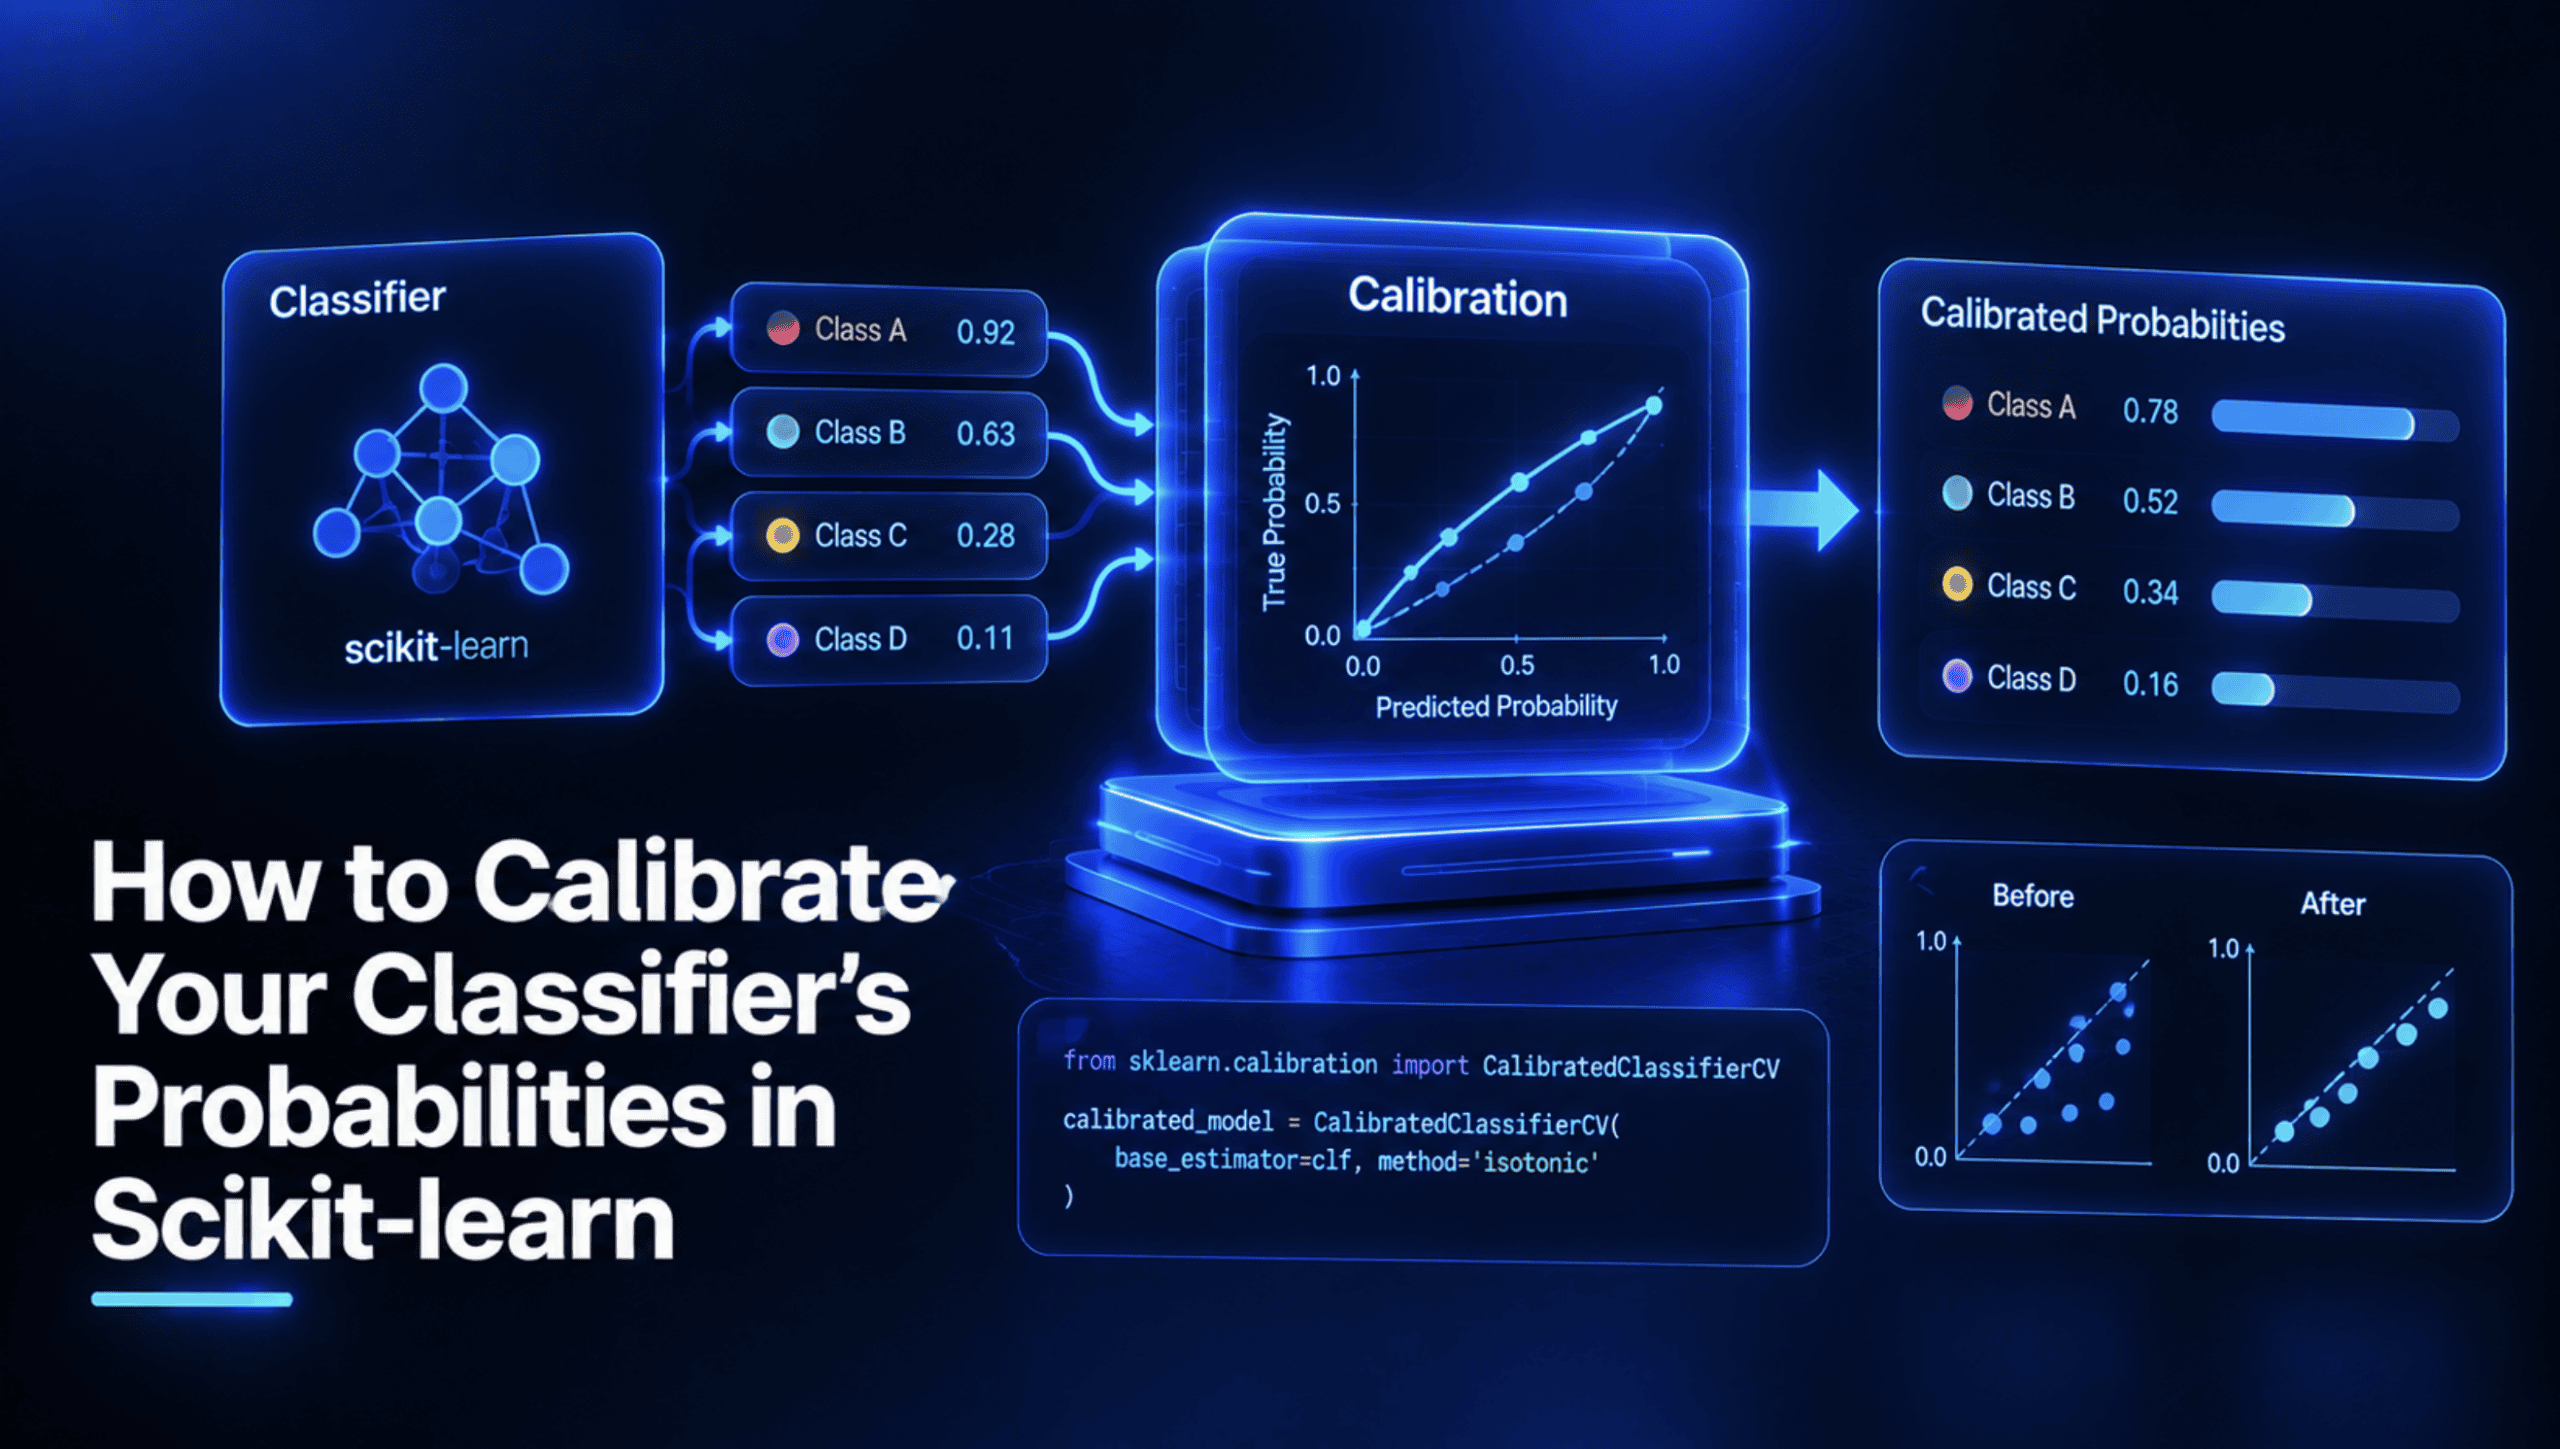
In einem Tutorial für KDnuggets zeigt Shittu Olumide, wie sich die Wahrscheinlichkeiten von Klassifikatoren in scikit-learn überprüfen und kalibrieren lassen. Die Anleitung beginnt mit dem Training zweier Klassifikatoren auf einem realen Datensatz. Anschließend macht sie deren Fehlkalibrierung mit einem Zuverlässigkeitsdiagramm und dem Brier-Score sichtbar. Damit verbindet das Tutorial eine grafische Darstellung mit einer Kennzahl, bevor es zur Korrektur übergeht. Dafür kommen zwei Verfahren zum Einsatz: die Platt-Skalierung und die isotone Regression. Der Ablauf reicht somit vom Modelltraining über die Prüfung der ausgegebenen Wahrscheinlichkeiten bis zu ihrer Kalibrierung. Im Mittelpunkt steht die Frage, wie sich eine Fehlkalibrierung erkennen lässt und welche Verfahren die Anleitung zu ihrer Korrektur einsetzt.