Zurück zur Übersicht
9 wichtige Kennzahlen für die LLM-Inferenz in fünf Minuten erklärt
Technische AnleitungLLMInferenzPerformance

9 wichtige Kennzahlen für die LLM-Inferenz in fünf Minuten erklärt

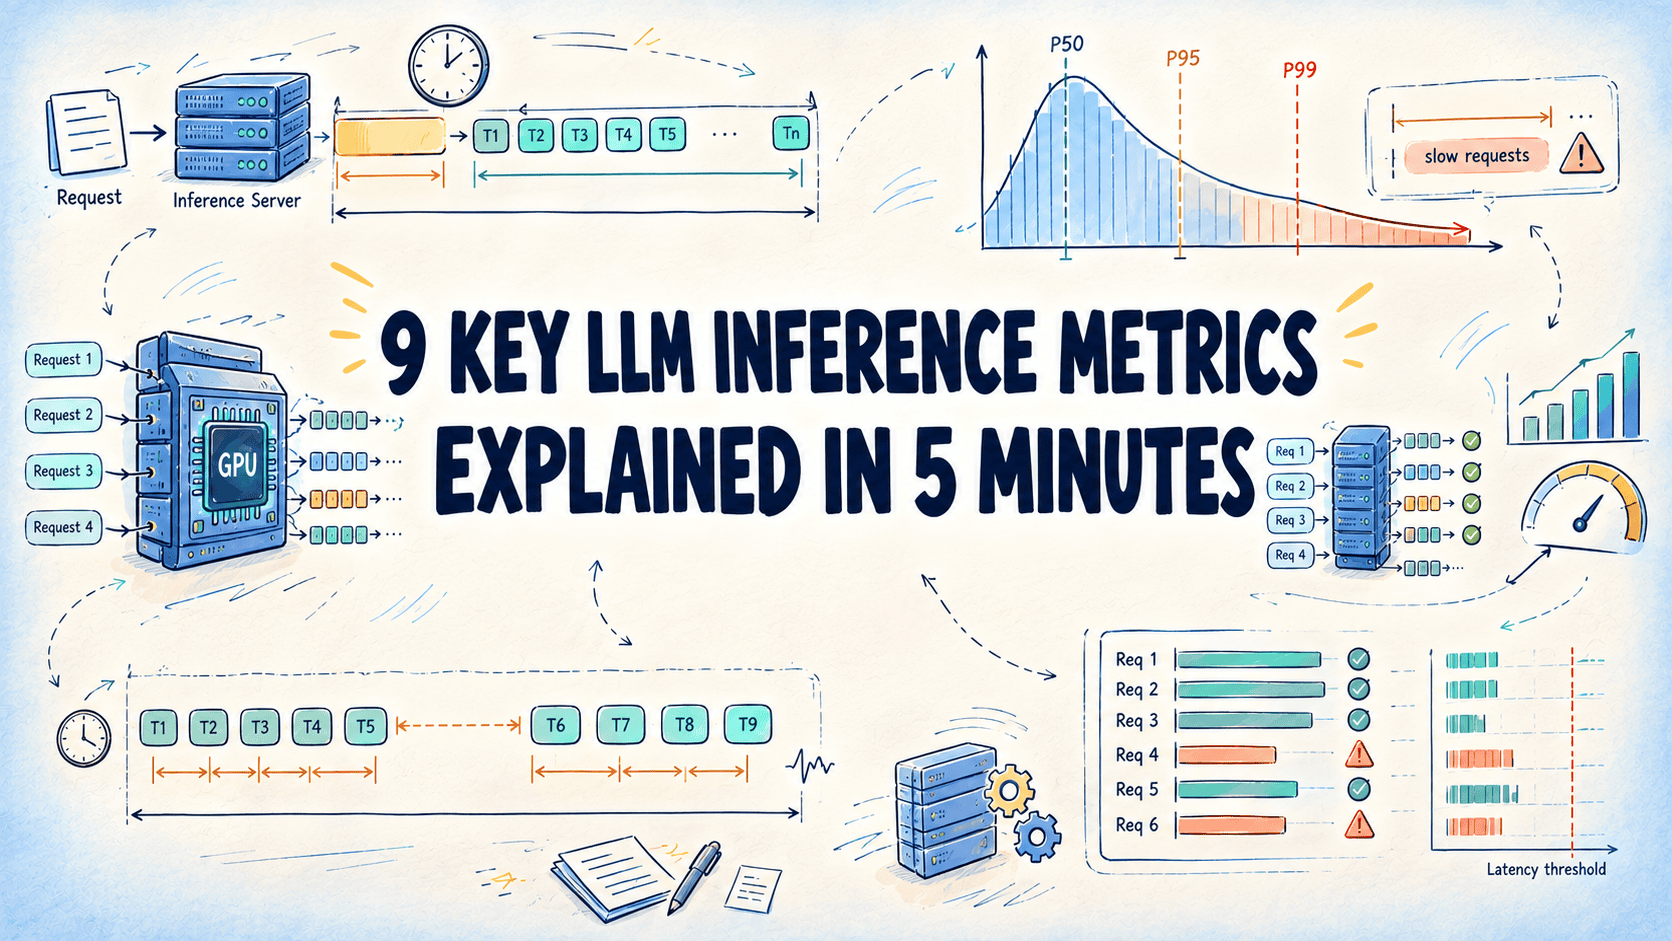
Dieser Analyseartikel beleuchtet die Grundlagen zur Messung der Leistung von Large Language Models (LLMs) bei der Inferenz. Anhand von neun wesentlichen Kennzahlen und Formeln wird veranschaulicht, wie Aspekte wie Latenz, Token-Generierungsgeschwindigkeit und Systemlast präzise erfasst und bewertet werden können. Der Beitrag richtet sich an Entwickler und Fachleute, die die Performance von KI-Inferenzsystemen verstehen und analysieren möchten, ohne dabei spekulative oder externe Details einzubeziehen.

KDnuggets

Die wichtigsten Punkte

  • Einführung in die Messung der LLM-Inferenzleistung anhand von neun zentralen Kennzahlen.
  • Verwendung spezifischer Formeln zur Bestimmung von Leistungswerten.
  • Fokus auf Kernbereiche wie Latenz, Token-Generierungsgeschwindigkeit und Systemlast.

Analyse

Grundlagen der LLM-Inferenzmessung

Die Messung der Leistung von Large Language Models während der Inferenzphase ist ein entscheidender Schritt zur Bewertung von Systemen. Der Originalbeitrag von KDnuggets, verfasst von Bala Priya C, bietet eine strukturierte Übersicht über neun wesentliche Metriken. Diese Kennzahlen ermöglichen es, technische Abläufe bei der Ausführung von KI-Modellen quantitativ zu erfassen.

Fokus auf Latenz und Geschwindigkeit

Ein zentraler Aspekt der Analyse dreht sich um die Bestimmung von Antwortzeiten und der Effizienz der Modellausgabe. Dabei spielen Kennzahlen zur Latenz sowie zur Geschwindigkeit der Token-Generierung eine übergeordnete Rolle, um zu bewerten, wie schnell ein Sprachmodell auf Eingaben reagiert und Text sequenziell ausgibt.

Bewertung der Systemlast

Neben den geschwindigkeitsbezogenen Messwerten wird auch die Systemlast betrachtet. Diese Metriken helfen dabei nachzuvollziehen, wie stark Ressourcen beansprucht werden, wenn ein LLM Inferenzaufgaben ausführt. Alle genannten Bereiche stützen sich direkt auf die im Original definierten Grundkonzepte.

Bedeutung für die KI-Branche

Die präzise Erfassung von Leistungsmetriken ist für den Betrieb und die Optimierung von KI-Anwendungen unerlässlich. Durch standardisierte Kennzahlen für Latenz, Token-Generierungsgeschwindigkeit und Systemlast können Entwickler die Effizienz von Large Language Models besser bewerten und vergleichen. Dies trägt dazu bei, die Skalierbarkeit und Ressourcennutzung von Inferenzsystemen in der Praxis nachvollziehbar zu analysieren.

Häufig gestellte Fragen

Welche Kernbereiche werden bei den LLM-Inferenzmetriken gemessen?

Die Messungen konzentrieren sich auf Latenz, Token-Generierungsgeschwindigkeit und Systemlast.

Woher stammen die Grundlagen dieser Kennzahlen?

Die Informationen basieren auf dem Artikel von Bala Priya C auf KDnuggets zur Erklärung von neun wichtigen LLM-Inferenzmetriken.
Ähnliche Nachrichten

Sichere Sandbox für KI-Agenten wählen: LangChain nennt vier Themen für die Auswahl
Technische Anleitung

Sichere Sandbox für KI-Agenten wählen: LangChain nennt vier Themen für die Auswahl

LangChain stellt die Frage, wie sich eine sichere Sandbox für KI-Agenten auswählen lässt. Die Kurzmeldung nennt vier Themen, zu denen der Beitrag Orientierung geben soll: die Isolierung des Dateisystems, den Netzwerkzugriff, die Begrenzung von Ressourcen und MicroVMs. Damit gibt die Meldung einen Überblick über die Themen des Leitfadens, ohne dessen Empfehlungen im Einzelnen wiederzugeben. Aus der Kurzbeschreibung geht weder hervor, wie LangChain die vier Themen gewichtet, noch welche Einstellungen oder Lösungen der Beitrag empfiehlt. Auch die Rolle von MicroVMs bei der Auswahl wird nicht näher erläutert. Die Meldung lässt sich daher als Einstieg in die Auswahlfrage lesen, nicht als konkrete Entscheidungshilfe für eine bestimmte Sandbox.

Implementierung proaktiver, dauerhafter Agents mit dem Schedules SDK in Managed Deep Agents von LangChain
Technische Anleitung

Implementierung proaktiver, dauerhafter Agents mit dem Schedules SDK in Managed Deep Agents von LangChain

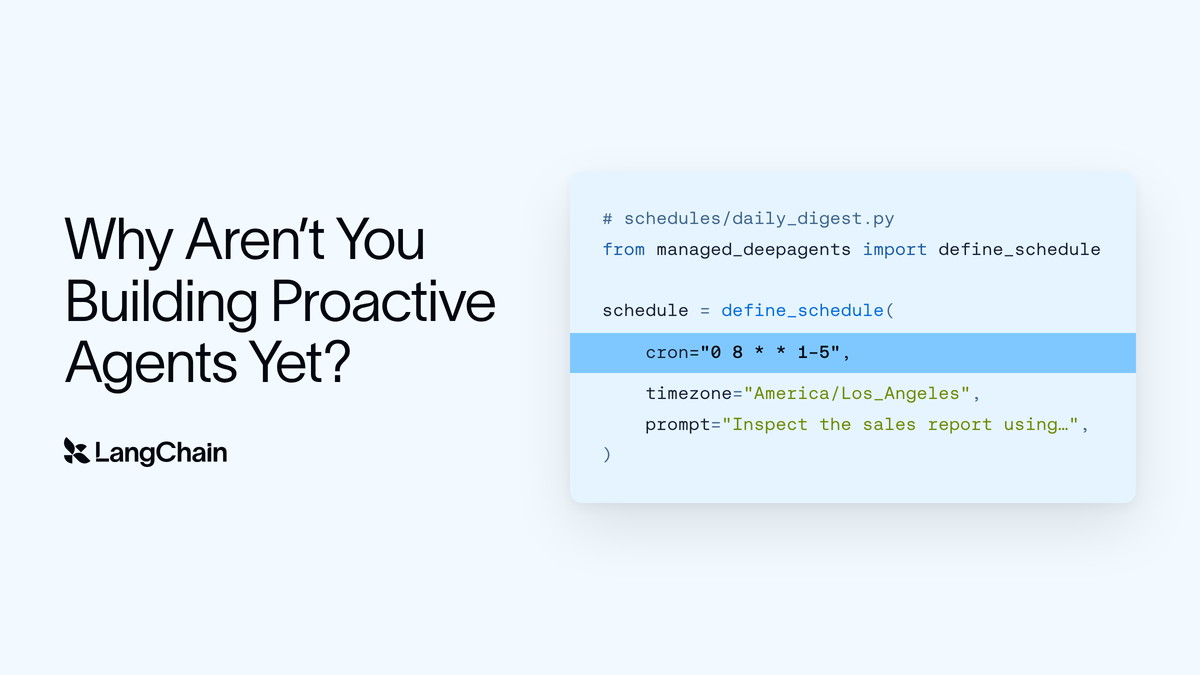
LangChain hat Informationen zur Entwicklung von proaktiven, 'Always-On'-Agents veröffentlicht, die das Schedules SDK innerhalb der Managed Deep Agents nutzen. Während viele dieser Agents bisher auf einfachen Cron-Jobs basierten, bietet das neue SDK erweiterte Möglichkeiten. Der Artikel beleuchtet, wie geplante Ausführungen („Scheduled Runs“) Funktionen wie ein verbessertes Gedächtnis und intelligente Triage-Prozesse freischalten können. Entwickler erfahren, wie sie diese Funktionen in ihre Managed Deep Agents integrieren, um deren Leistungsfähigkeit und Automatisierungsgrad zu steigern. Diese Entwicklung markiert einen Schritt weg von simplen zeitgesteuerten Skripten hin zu robusteren, proaktiven KI-Systemen, die eigenständig agieren und auf komplexe Anforderungen in Echtzeit reagieren können.

Klassifikator-Wahrscheinlichkeiten in scikit-learn kalibrieren: Fehlkalibrierung erkennen und mit zwei Verfahren korrigieren
Technische Anleitung

Klassifikator-Wahrscheinlichkeiten in scikit-learn kalibrieren: Fehlkalibrierung erkennen und mit zwei Verfahren korrigieren

In einem Tutorial für KDnuggets zeigt Shittu Olumide, wie sich die Wahrscheinlichkeiten von Klassifikatoren in scikit-learn überprüfen und kalibrieren lassen. Die Anleitung beginnt mit dem Training zweier Klassifikatoren auf einem realen Datensatz. Anschließend macht sie deren Fehlkalibrierung mit einem Zuverlässigkeitsdiagramm und dem Brier-Score sichtbar. Damit verbindet das Tutorial eine grafische Darstellung mit einer Kennzahl, bevor es zur Korrektur übergeht. Dafür kommen zwei Verfahren zum Einsatz: die Platt-Skalierung und die isotone Regression. Der Ablauf reicht somit vom Modelltraining über die Prüfung der ausgegebenen Wahrscheinlichkeiten bis zu ihrer Kalibrierung. Im Mittelpunkt steht die Frage, wie sich eine Fehlkalibrierung erkennen lässt und welche Verfahren die Anleitung zu ihrer Korrektur einsetzt.