
DuckLake vom DuckDB-Team: Offenes Lakehouse-Tabellenformat mit stabiler Version 1.0 und Parquet-Speicherung
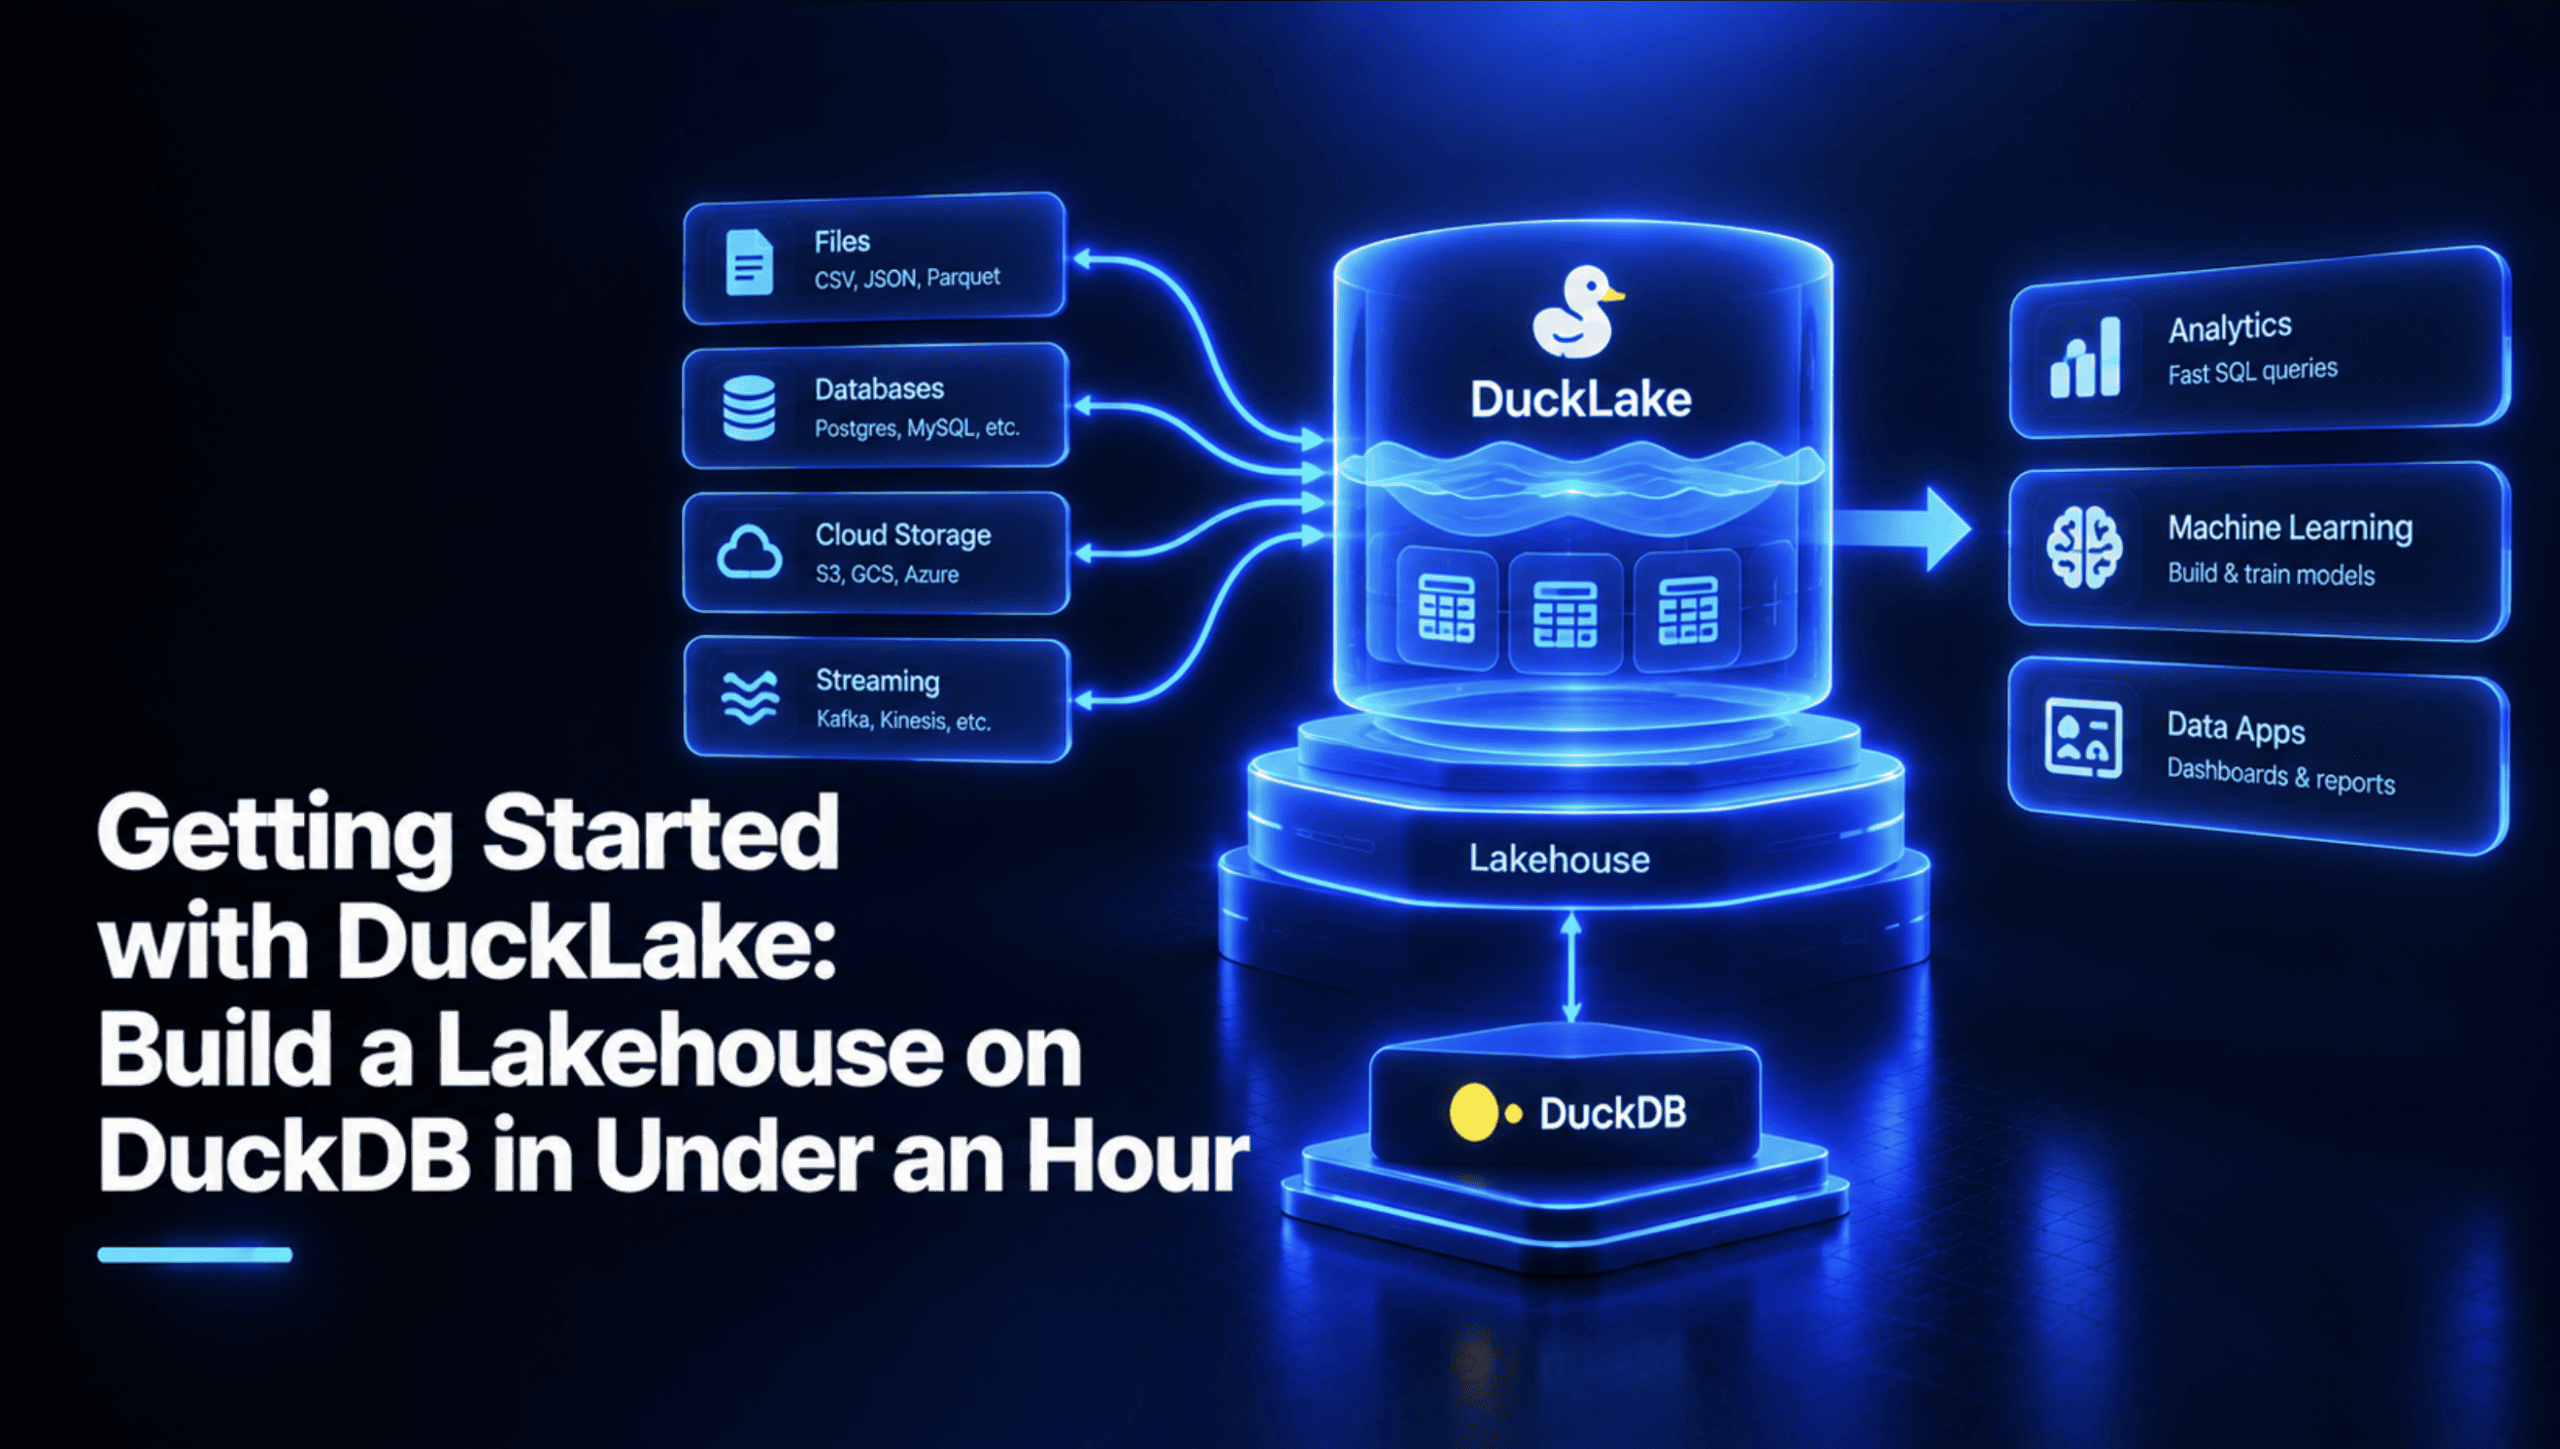
Das DuckDB-Team stellt mit DuckLake ein offenes Lakehouse-Tabellenformat bereit. Das System trennt Daten und Metadaten strukturell voneinander: Während die Tabellen-Metadaten in einer relationalen SQL-Datenbank verwaltet werden, liegen die eigentlichen Nutzdaten in Parquet-Dateien vor. Im April 2026 wurde DuckLake in Version 1.0 veröffentlicht. Diese Version zeichnet sich durch eine stabile Spezifikation aus und gewährleistet volle Abwärtskompatibilität für Anwender. Die Architektur ermöglicht den zügigen Aufbau einer Lakehouse-Struktur auf Basis von DuckDB, indem sie standardisierte Dateiformate mit relationaler Metadatenverwaltung verknüpft.
Die wichtigsten Punkte
- Offenes Format: DuckLake ist ein offenes Lakehouse-Tabellenformat, das direkt vom DuckDB-Team entwickelt wurde.
- Zweiteilige Architektur: Die Metadaten der Tabellen werden in einer SQL-Datenbank gesichert, während die Nutzdaten in Parquet-Dateien gespeichert werden.
- Version 1.0: Das Format erschien im April 2026 in der Version 1.0 mit einer stabilen Spezifikation.
- Zukunftssicherheit: DuckLake 1.0 bietet eine garantierte Abwärtskompatibilität für bestehende Implementierungen.
Analyse
Struktur und Architektur von DuckLake
DuckLake verfolgt als offenes Lakehouse-Tabellenformat einen klar definierten architektonischen Ansatz. Das Format teilt die Verwaltung der Datenbestände in zwei funktionale Ebenen auf:
- Metadatenverwaltung: Die Metadaten der Tabellen werden vollständig innerhalb einer SQL-Datenbank vorgehalten. Dies erlaubt eine strukturierte und relationale Handhabung von Schemainformationen und Tabelleneigenschaften.
- Datenspeicherung: Die eigentlichen Datensätze verbleiben getrennt von den Metadaten und werden in standardisierten Parquet-Dateien abgelegt.
Durch diese Entkopplung von Metadaten und Speicherdateien kombiniert DuckLake bewährte Prinzipien von SQL-Datenbanksystemen mit den Vorteilen dateibasierter Speicherstrukturen.
Stabilität und Meilenstein mit Version 1.0
Ein wesentlicher Entwicklungsschritt für das Projekt war die Veröffentlichung von DuckLake 1.0 im April 2026. Mit diesem Meilenstein ging das Tabellenformat in ein Stadium mit stabiler Spezifikation über.
Ein zentraler Aspekt dieser Veröffentlichung ist die garantierte Abwärtskompatibilität. Für Entwickler und Datenverantwortliche bedeutet dies, dass auf Version 1.0 basierende Datenarchitekturen verlässlich betrieben werden können, ohne Inkompatibilitäten bei künftigen Weiterentwicklungen der Spezifikation befürchten zu müssen.
Bedeutung für die KI-Branche
Für datenintensive Anwendungen und KI-Systeme spielen offene Tabellenformate im Lakehouse-Umfeld eine zentrale Rolle bei der Datenorganisation. Die Speicherung von Daten in Parquet-Dateien stellt sicher, dass Roh- und Verarbeitungsdaten in einem weit verbreiteten, effizienten Format vorliegen, welches standardmäßig in Analyse- und Modellierungsprozessen genutzt wird.
Indem DuckLake Tabellen-Metadaten in einer SQL-Datenbank verwaltet und Abwärtskompatibilität garantiert, bietet es eine stabile Grundlage für Datenpipelines, die strukturierte Datenbestände konsistent und langfristig verfügbar halten müssen.
Häufig gestellte Fragen
Was ist DuckLake?
DuckLake ist ein offenes Lakehouse-Tabellenformat, das vom Team hinter DuckDB entwickelt wurde.
Wie speichert DuckLake Daten und Metadaten?
DuckLake speichert die Metadaten der Tabellen in einer SQL-Datenbank. Die eigentlichen Nutzdaten werden separat in Parquet-Dateien abgelegt.
Wann erschien DuckLake 1.0 und was zeichnet diese Version aus?
DuckLake 1.0 wurde im April 2026 veröffentlicht. Die Version bietet eine stabile Spezifikation und garantiert Abwärtskompatibilität.


